У матеріалі розбирається підхід João Pedro Leite та команди Cloudflare до вибору алгоритму консенсусу QuePaxa для експериментального сервісу Meerkat.
Meerkat: консенсус для глобального керування
Meerkat — це внутрішній сервіс Cloudflare, який підтримує упорядкований лог подій між репліками. Кожен запис у логу приймається за допомогою алгоритму консенсусу, а поверх логу будується інтерфейс на кшталт key-value сховища: кожна подія — це операція get або put. Поки всі репліки бачать однакову послідовність подій, вони відновлюють однаковий KV-стан.
Подібний підхід використовують Consul, etcd, Apache ZooKeeper. Відмінність Meerkat у тому, що кластери розкидані по континентах і працюють через інтернет-канали з високою та сильно змінною затримкою. Багато популярних реалізацій Raft чи Multi-Paxos розраховані на локальні датацентри з жорсткими вимогами до затримок, а не на глобальну мережу.
Чому класичним алгоритмам важко у глобальній мережі
Автор описує конкретний інцидент 2020 року: частковий збій мережевого комутатора в Cloudflare не призвів до втрати даних, але система, що покладалася на консенсус, стала приймати записувальні операції в 80 разів повільніше приблизно 6 годин. Консенсус формально залишався коректним, проте сервіс став практично непридатним для записів.
Звідси вимога: алгоритм має продовжувати роботу не лише при падінні вузлів, а й при сплесках латентності та тимчасових розривах зв'язку. У глобальній мережі це основне джерело проблем.
Деструктивна інтерференція в Paxos
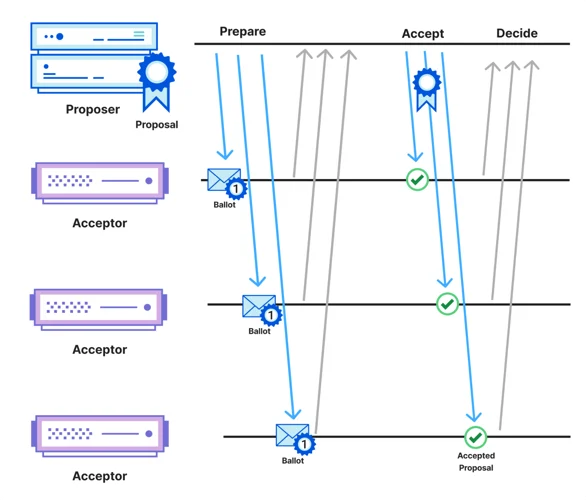
У базовому Paxos є два типи процесів: proposers та acceptors. Простіше кажучи, завдання — добитися, щоб більшість acceptor-ів погодили одне значення від якогось proposer-а. Алгоритм працює у дві фази: Prepare і Accept з номерами бюлетенів (ballot).
У Prepare будь-який proposer розсилає acceptor-ам номер бюлетеня. Acceptor-и обіцяють більше не приймати пропозиції з меншим номером. У Accept proposer відправляє конкретне значення з тим самим номером бюлетеня, і якщо більшість acceptor-ів усе ще «тримають» цей номер, пропозиція приймається.
Проблема починається, коли з'являється кілька proposer-ів одночасно. Кожен може «перебити» інший вищим номером бюлетеня між фазами Prepare і Accept. Вузли здатні нескінченно блокувати одне одного, постійно підвищуючи номери й так і не доходячи до рішення. Це явище автор називає деструктивною інтерференцією.
Чим більше одночасних proposer-ів, тим вища ймовірність застрягти в нескінченному процесі «перебивання». Формально Paxos не гарантує живучість (liveness) без припущення про часткову синхронність — що з певного моменту всі повідомлення проходять не пізніше деякої фіксованої затримки.
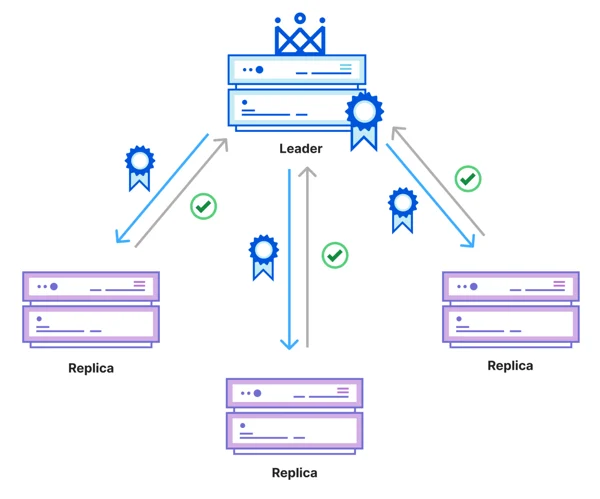
Щоб уникнути такого змагання, практичні протоколи на кшталт Raft, Multi-Paxos і Viewstamped Replication вводять лідера — єдиний процес, якому дозволено робити пропозиції. Це різко зменшує конфлікти та дає оптимальний шлях до рішення в один раунд-тріп, поки мережа й лідер у порядку.
Метастабільні збої та вибори лідера в Raft
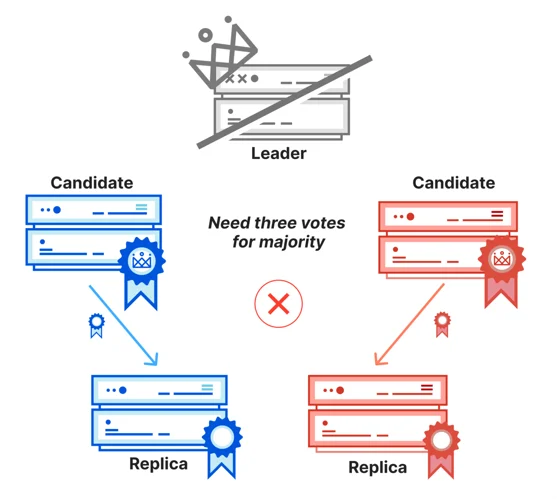
Лідер у такій схемі стає критичною точкою. Як тільки він падає, сповільнюється або втрачає зв'язок, протокол мусить замінити його через вибори. У Raft це робиться більшістю голосів: будь-яка репліка, яка «підозрює» падіння лідера, стає кандидатом і просить голоси інших. Якщо більшість за, вона стає новим лідером. Якщо ні — вибори повторюються.
Вибори страждають від тієї ж деструктивної інтерференції, що й Paxos: кілька кандидатів одночасно можуть блокувати одне одного, у результаті жоден не набирає більшість. Чим частіше вибори не вдаються, тим більше реплік пробують себе в ролі кандидата. Це перетворюється на метастабільний збій: короткий збій мережі (наприклад 2 секунди) ініціює вибори, вибори самі починають руйнувати нормальну роботу, і система продовжує «лікуватися» ще довго після того, як мережа вже відновилась.
Ідеальний алгоритм, з точки зору авторів Meerkat, взагалі не мав би стадії відновлення через перезалізування лідера — це занадто чутливий, складний і нестабільний механізм.
Обмеження детекторів збоїв у асинхронних мережах
Ще одна проблема лідерських протоколів — як вирішується, що лідер «помер». Жоден процес не може спостерігати збій іншого безпосередньо, лише відсутність очікуваних повідомлень. Тому застосовують серцебиття (heartbeats) та тайм-аути.
У глобальних мережах немає гарантованої верхньої межі затримки. Більшість пакетів приходить швидко, але іноді виникають сплески латентності та провали зв'язку. У такому середовищі детектор збоїв неминуче вгадує: це повільна мережа чи справжній збій сервера. Помилка в цей бік запускає зайві вибори лідера, а доки вони тривають, система не обробляє запити.
Навіть коли детектор «вгадує» правильно, швидкість реакції обмежена затримкою мережі. Тайм-аут не може бути меншим за типовий RTT, і зазвичай в Raft налаштовується приблизно як 5-10 RTT. Для маршрутів через півсвіту це означає близько секунди простою до моменту, коли збій лідера взагалі буде помічений.
Чому Cloudflare обрала саме QuePaxa
Команда Meerkat відмовилася від алгоритмів, які спираються на «сильного» лідера й точні тайм-аути. Пошук був сфокусований на протоколах, придатних для асинхронних мереж, де немає надійних меж затримок. Так вони звернулися до QuePaxa (Tennage & Băsescu et al., 2023).
Ключова властивість QuePaxa за описом авторів — здатність:
- за сприятливих умов досягати рішення за один раунд-тріп;
- при погіршенні мережі або збоях вузлів не ламатися, а лише поступово деградувати по продуктивності.
Це реалізовано через три дизайнерські рішення:
- необов'язковий лідер, а не єдине джерело істини;
- відсутність залежності від детекції збоїв як умови прогресу;
- конструктивна інтерференція proposers замість конкуренції.
Базова модель QuePaxa: proposers і recorders
У QuePaxa два типи ролей:
- Proposers — приймають клієнтські запити і висувають пропозиції;
- Recorders — проміжна ланка, яка фіксує всі побачені пропозиції й допомагає їх поширювати.
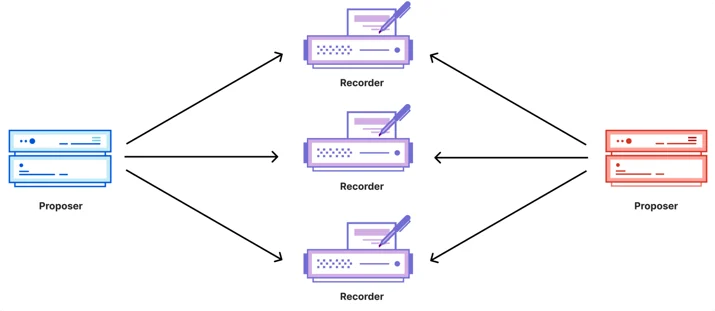
Головна ідея: proposers не намагаються «перемогти» один одного, а поступово сходяться до однієї, найпріоритетнішої пропозиції. Кожна пропозиція має пріоритет — випадкове число; у лідера — максимальний можливий пріоритет.
Поведінка узагальнено:
- proposer надсилає свою пропозицію recorders;
- recorders ретранслюють найкращі (з точки зору пріоритету) пропозиції до інших proposers;
- якщо proposer отримує кращу пропозицію, ніж його власна, він усиновлює її й надалі розсилає вже її.
У результаті, замість нескінченно наростаючого конфлікту, як у Paxos, чим більше учасників пропонує щось, тим вищі шанси, що всі перейдуть до однієї, найпріоритетнішої пропозиції.
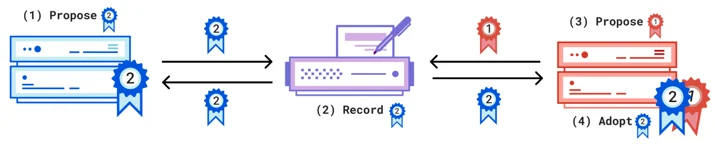
Алгоритм при цьому рандомізований: випадкові пріоритети не дають жорсткої гарантії, що з першої спроби буде обрано глобально найвищий пріоритет. Однак гарантовано, що за достатньої кількості раундів proposers зійдуться на одній пропозиції.
Необов'язковий лідер і hedging
Окремий proposer позначається як лідер. Він має максимальний пріоритет і єдиний, хто може прийти до рішення за один раунд-тріп. Але клієнти не зобов'язані звертатися саме до лідера: будь-який proposer може прийняти запит і спробувати його провести.
Важливий практичний момент — hedging клієнтів:
- клієнт відправляє запит на усі репліки;
- не лідерські репліки чекають невеликий hedging timeout, даючи лідеру шанс швидко вирішити пропозицію;
- якщо це не стається, вони самі стають активними proposers.
У реалізації Cloudflare, за словами автора, тайм-аут чекає клієнт, щоб не розмножувати зайві мережеві повідомлення, але суть та сама.
Критично, що цей hedging timeout — не детектор збою:
- його можна зробити дуже малим, він не прив'язаний до RTT мережі;
- помилка в оцінці не зупиняє систему, а лише збільшує кількість активних proposers;
- наслідок — вищі витрати трафіку й, можливо, більше раундів для прийняття рішення.
Це дає гнучкий компроміс: менший тайм-аут — швидша реакція на уповільнення або збій лідера, ціною додаткового трафіку та деякого падіння пропускної спроможності.
Як підсумовує автор, у разі падіння лідера QuePaxa може «відновитися» настільки швидко, наскільки це дозволяє обраний hedging timeout. Немає очікування повільних або помилкових детекторів збоїв, оскільки будь-хто може почати пропонувати.
Чотири фази та раунди QuePaxa
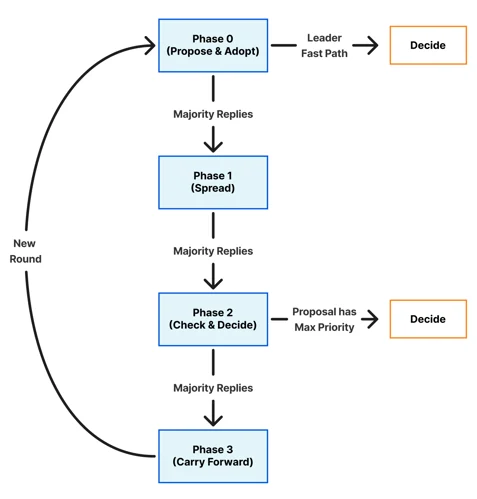
QuePaxa працює серіями раундів, кожен складається з чотирьох фаз. На старті кожної фази proposer розсилає свою поточну пропозицію всім recorders і переходить далі, отримавши відповіді від більшості.
- Фаза 0 (Propose and Adopt): non-leader proposers вибирають випадковий пріоритет, надсилають пропозиції, приймають найвищий пріоритет із більшості відповіді. Лідер має фіксований максимальний пріоритет. Якщо в першому раунді лідер бачить, що більшість відповіло саме з його пропозицією, він одразу вирішує.
- Фаза 1 (Spread): proposers розсилають узяту пропозицію, recorders запам'ятовують найвищу побачену пропозицію для цієї фази.
- Фаза 2 (Check and Decide): proposers запитують у більшості recorders найвищу пропозицію, яку ті бачили в попередній фазі. Якщо це збігається з їхньою поточною пропозицією, вони вирішують її.
- Фаза 3 (Carry Forward): ті, хто не зміг вирішити, ще раз збирають від більшості recorders найкращі пропозиції, приймають їх і переходять у наступний раунд уже зі «свіжими» знаннями кластера.
Фаза 0: швидкий шлях лідера і випадковість
Фаза 0 одночасно вирішує кілька завдань:
- генерує випадкові пріоритети для non-leader proposer-ів (щоб обійти обмеження теореми FLP у чисто детермінованому асинхронному світі);
- дає лідеру шанс на «fast path» в один раунд-тріп, якщо він першим дійшов до більшості recorders;
- починає зближення інших proposer-ів до лідерської пропозиції.
Критична властивість, на яку спирається безпека швидкого шляху, — перетин більшостей (majority intersection): будь-які дві множини recorders більшості розміру n/2+1 мають спільний вузол. Якщо лідер досяг більшості хоча б у одній фазі, будь-який інший proposer, який запитує більшість, обов'язково побачить лідерську пропозицію й буде змушений прийняти її, оскільки у неї максимальний пріоритет.
Фази 1-3: повільний шлях і конструктивна кооперація
Коли є одночасні proposers і лідеру не вдається миттєво отримати більшість, вступає «повільний» шлях через усі фази:
- у Фазі 1 recorders фіксують найвищу пропозицію, яку бачили, гарантуючи, що в наступній фазі рішення не буде ухвалене за значення з нижчим пріоритетом;
- у Фазі 2 кожен proposer перевіряє, чи «переважили» його якусь іншу пропозицію: якщо з більшості повертається щось із вищим пріоритетом, вирішувати свою пропозицію не можна;
- у Фазі 3 усі, хто не вирішив, переходять до найкращої відомої пропозиції, створюючи передумови для успіху наступного раунду.
За описом авторів, ймовірність отримати рішення в кожному раунді теоретично оцінюється близько 50 %, але на практиці через поступове зближення (carry forward) вона істотно вища.
Як QuePaxa поводиться в Meerkat на практиці
У випробуваннях Meerkat на серверах, розкиданих майже по всіх континентах, команда Cloudflare спостерігала, як QuePaxa впливає на продуктивність та доступність.
- Система продовжує приймати запити, навіть коли лідер падає, втрачає зв'язок або стає повільним. За словами автора, команда не бачила повної зупинки кластера.
- Близько 95 % рішень приймаються лідером у Фазі 0 по швидкому шляху. Це дає стабільний високий throughput у нормальних умовах.
- Коли консенсус не вдається в першій фазі, рішення відсувається до Фази 2 (трьох раунд-тріпів). Пропускна спроможність тимчасово падає до приблизно третини номінальної, але система продовжує працювати.
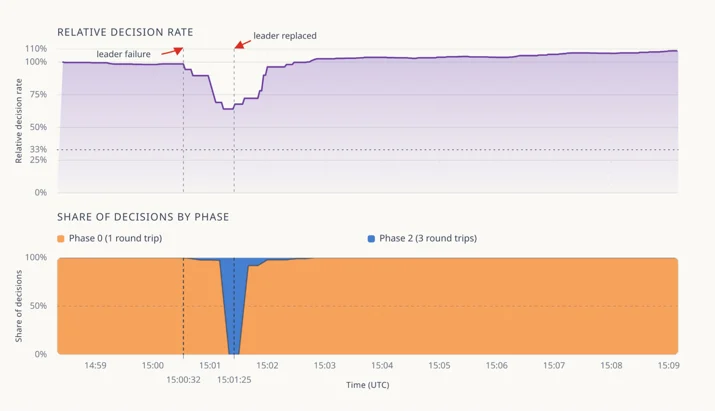
Окремо відзначається, що QuePaxa дозволяє впевнено міняти лідера «на льоту». Оскільки лідер не є єдиним двигуном прогресу, тимчасово неоптимальний вибір лідера лише погіршує частку «швидких» рішень, але не блокує систему повністю — на відміну від звичайних лідерських алгоритмів.
Обмеження підходу й наступні кроки Cloudflare
У тексті наголошується, що вибір QuePaxa — це свідомий перехід на менш вивчену територію. На момент публікації алгоритм не має такого ж бойового досвіду, як Raft чи Multi-Paxos. Крім того, оригінальний протокол розроблявся в моделі crash-stop, тоді як команда Cloudflare розширює його для підтримки crash recovery.
Через це вони інвестують у:
- формальну верифікацію реалізації QuePaxa й Meerkat в цілому;
- масштабне моделювання та fault-injection тести, щоб програвати складні для відтворення збої;
- подальші бенчмарки та аналіз того, як академічний протокол перетворюється на виробничу систему.
У наступних публікаціях, за анонсом автора, команда планує детальніше розповісти саме про верифікацію Rust-імплементації QuePaxa, тестування рідкісних сценаріїв збоїв та вимірювання продуктивності.
Джерело: João Pedro Leite — Cloudflare Blog