У changelog Cloudflare описується новий режим роботи AI Search: тепер як джерело даних можна використовувати базу D1. Цей підхід зручний, коли контент уже живе в SQL-таблицях, а не у вигляді файлів або вручну доданих документів.
Що саме змінилося
AI Search отримав ще один тип джерела даних — d1. Це означає, що:
- ви вказуєте SQL-запит до бази D1,
- AI Search виконує його в режимі тільки читання,
- кожен рядок результату стає окремим документом пошуку,
- планові синхронізації (scheduled syncs) оновлюють індекс, коли рядки додаються, змінюються або видаляються.
На рівні інтерфейсу з'явилася можливість створювати екземпляри AI Search, які підживлюються з D1 — через дашборд, REST API або Workers binding.
Як створити AI Search з D1 через дашборд
У дашборді Cloudflare під час створення AI Search-екземпляра можна вибрати D1 як джерело:
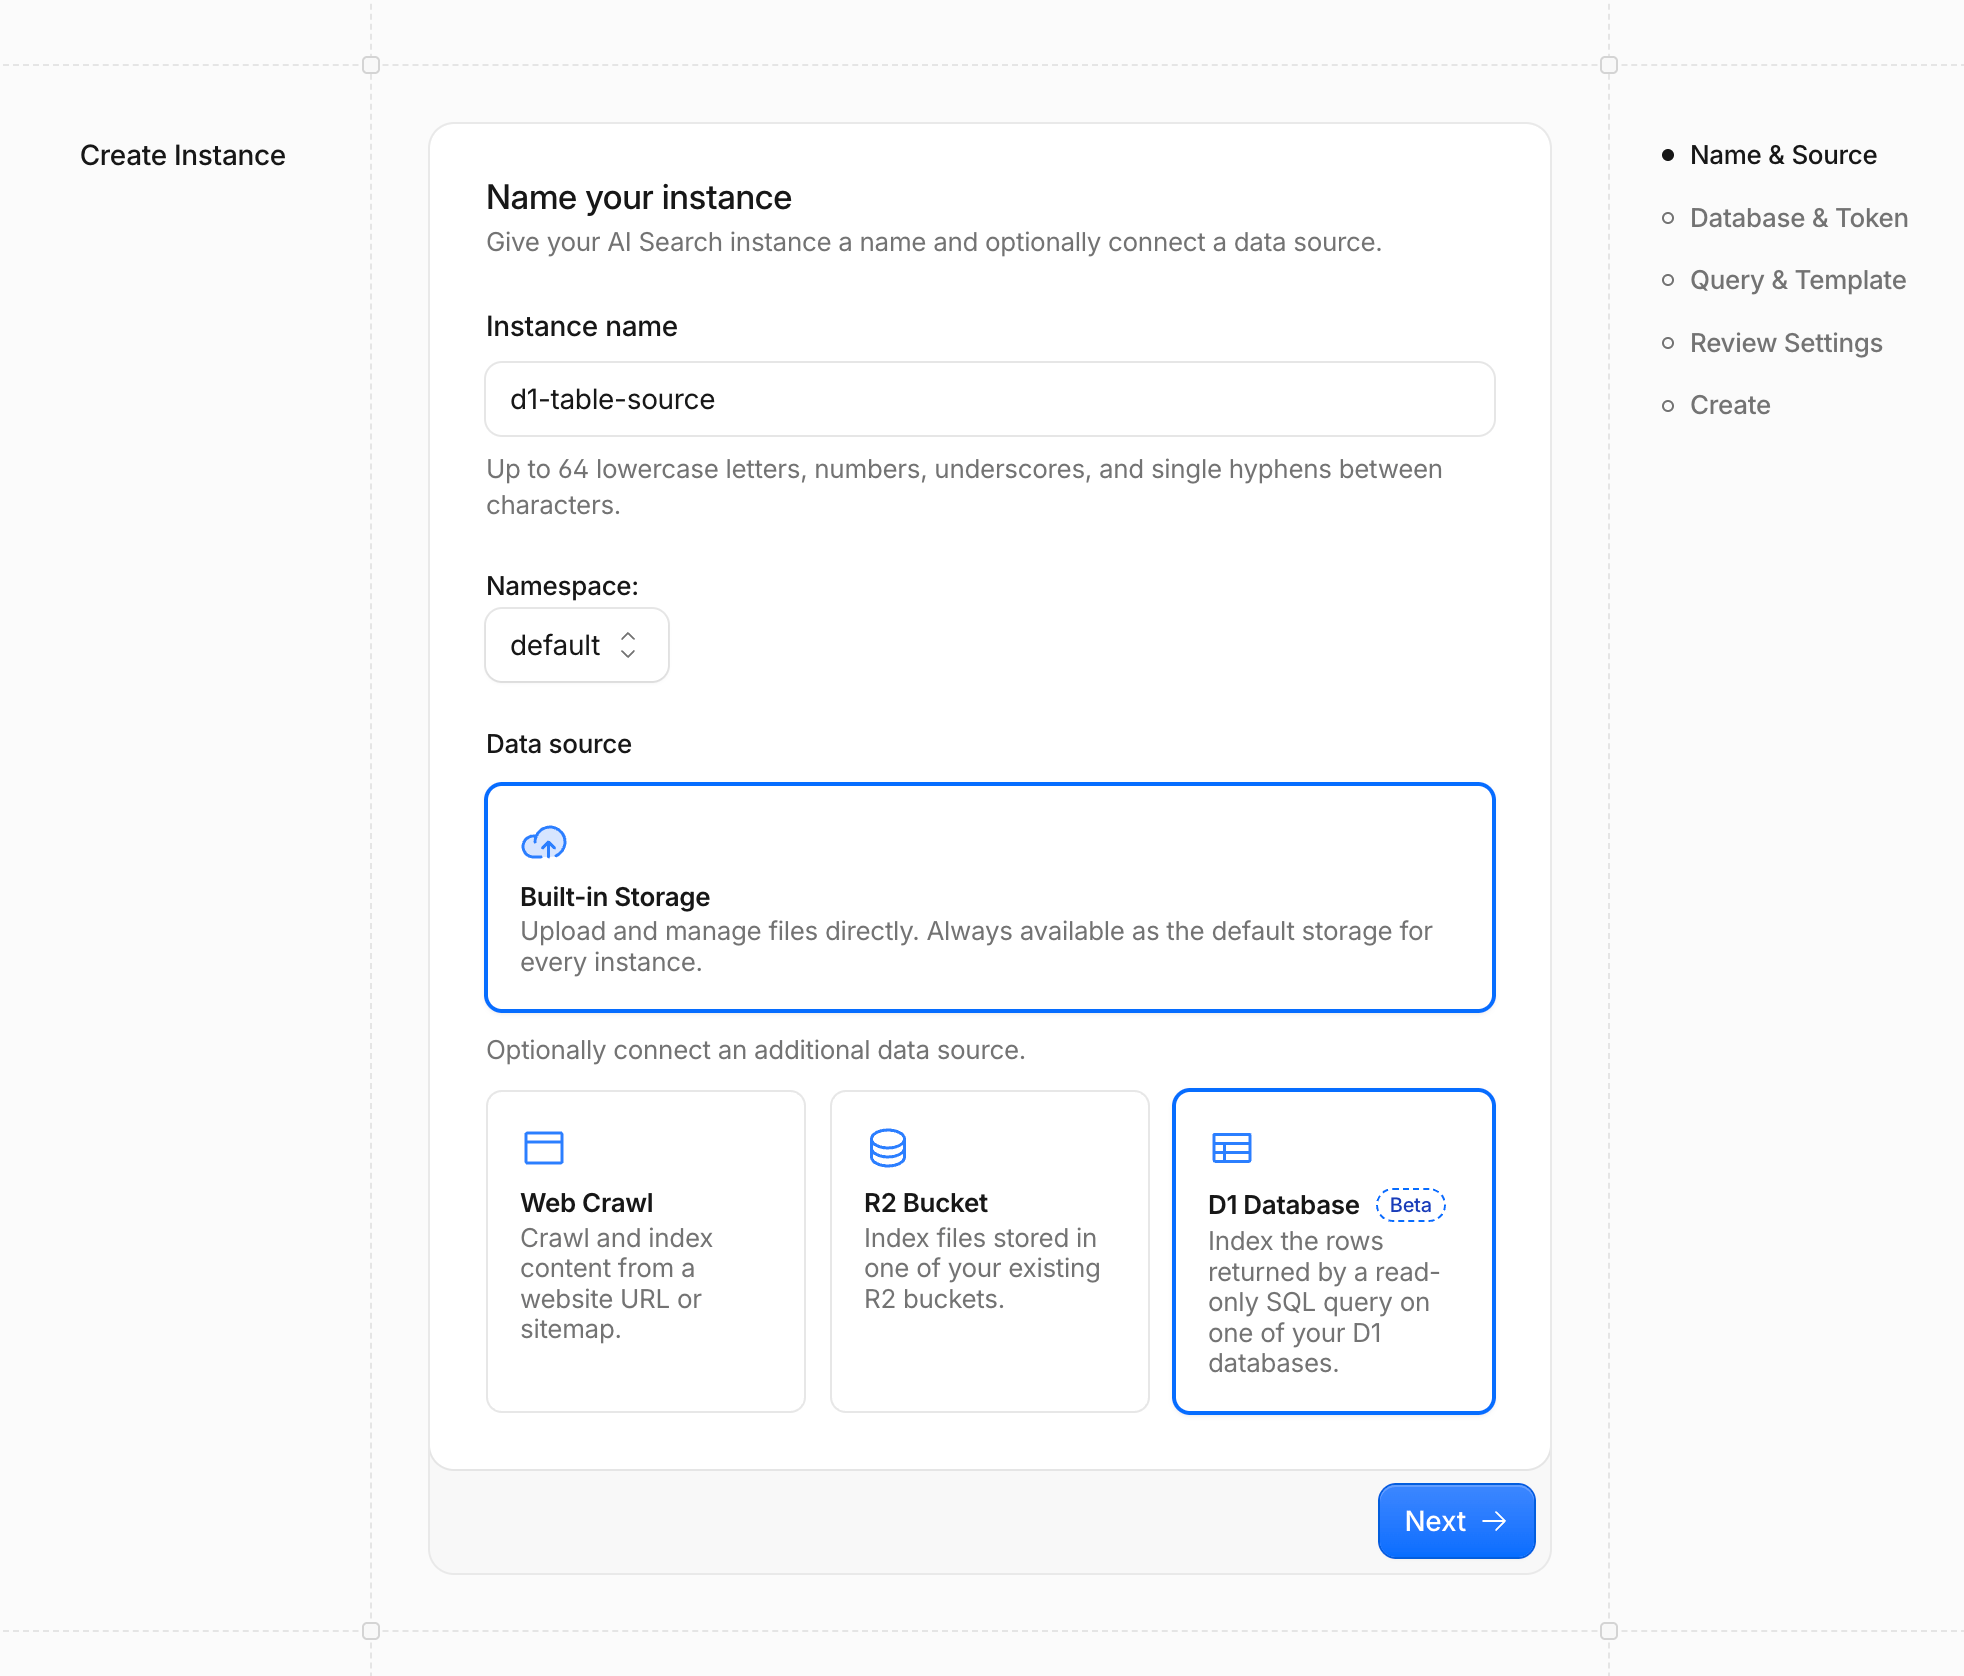
Схема дій виглядає так:
- Створити або вибрати наявну базу D1 (структура таблиць уже має існувати).
- У розділі AI Search створити новий instance.
- Обрати тип джерела
D1та конкретну базу. - Задати SQL-запит, який повертає рядки для індексації.
- Налаштувати розклад синхронізації, якщо потрібно, щоб індекс оновлювався автоматично.
Запит виконується тільки на читання, тому логіка оновлення і видалення записів залишається на стороні вашої програми або інших процесів, які працюють з D1.
Структура SQL-запиту і полів документа
AI Search очікує, що кожен рядок результату буде конвертований в документ. У прикладі з changelog індексуються статті з бази знань (help center):
curl -X POST "https://api.cloudflare.com/client/v4/accounts/<ACCOUNT_ID>/ai-search/namespaces/default/instances" \
  -H "Authorization: Bearer <API_TOKEN>" \
  -H "Content-Type: application/json" \
  --data '{
    "id": "help-center",
    "type": "d1",
    "source": "<D1_DATABASE_ID>",
    "token_id": "<SERVICE_TOKEN_ID>",
    "source_params": {
      "d1": {
        "query": "SELECT article_id AS id, title, content, category AS meta_category\nFROM articles\nWHERE published = 1"
      }
    }
  }'
Ключові моменти цього запиту:
SELECT article_id AS id— явний aliasid. Це поле часто використовується як унікальний ідентифікатор документа в індексі.title, content— текстові поля, які логічно зробити основою для пошуку (назва й основний вміст статті).category AS meta_category— приклад того, як через alias можна передати метадані в окреме поле документа.WHERE published = 1— фільтр, що відбирає тільки опубліковані статті, щоб чернетки не з'являлися в результатах AI Search.
З практичної точки зору варто:
- завжди віддавати явне
id(наприклад, первинний ключ таблиці), - чітко розділяти текст для повнотекстового пошуку (title, content) і метадані для фільтрації (категорія, тег, статус),
- обмежувати результат фільтрами
WHERE, щоб у індекс не потрапляли службові або застарілі рядки.
Створення D1-підключеного AI Search через REST API
Окрім дашборду, той самий результат можна отримати через API. У фрагменті з changelog показано створення екземпляра help-center у default namespace:
id— ім'я instance (help-center),type: "d1"— вибір саме D1 як типу джерела,source— ідентифікатор бази D1,token_id— service token, через який AI Search буде мати доступ до D1,source_params.d1.query— SQL-запит, що визначає склад документів.
Ключова особливість — подальша робота з цим instance аналогічна іншим типам джерел: можна виконувати пошукові запити до індексу, а синхронізацією і повторним виконанням SQL-запиту керує сам AI Search.
Використання D1 з AI Search у Workers
У тексті changelog згадується ще один шлях — створення D1-backed instance через Workers binding. Це підхід, коли ви керуєте інфраструктурою AI Search з коду Worker:
- у Worker є binding до D1,
- той самий Worker може викликати REST API AI Search,
- логіку створення та оновлення AI Search instance можна інкапсулювати в коді (наприклад, під час деплойменту або міграцій).
Такий спосіб корисний, коли конфігурацію потрібно тримати в репозиторії поруч із кодом, а не налаштовувати вручну через дашборд.
Обмеження та нюанси використання D1 як джерела
За описом Cloudflare, AI Search працює з D1 у режимі тільки читання. Це має декілька наслідків:
- індекс не змінює дані у вашій базі — виправлення або видалення контенту відбувається у самому D1,
- актуальність результатів залежить від розкладу синхронізацій — між оновленням рядка в D1 та оновленням індексу буде затримка,
- SQL-запит потрібно продумувати так, щоб у результат не потрапляли тимчасові або технічні дані, які згодом буде складно відфільтрувати вже на рівні пошуку.
Оскільки це beta-функціональність, варто враховувати можливі зміни API й обмеження, описані в офіційній документації.
Де подивитися деталі конфігурації
За додатковою інформацією Cloudflare відсилає до розділу документації D1 data source. Там можна знайти:
- повний перелік полів конфігурації для
type: "d1", - вимоги до SQL-запиту,
- деталі аутентифікації та роботи із service tokens,
- актуальні обмеження beta-режиму.
Якщо ви вже зберігаєте структурований контент у D1, цей режим дає змогу побудувати поверх нього пошук на AI Search без дублювання даних в окреме сховище.
Джерело: Cloudflare Changelog