Архівний матеріал: розбір публікації від 2024-05-23. Назви функцій, інтерфейс, можливості плагінів і умови доступу наведені в контексті того часу.
У публікації Smashing Magazine розбирається підхід кількох авторів і команд до тієї ж самої проблеми: як перестати ламати голову над назвами токенів, шарів, змінних і компонентів та зробити систему назв керованою. Нижче — практичний конспект ідей, які можна адаптувати під ваш проєкт.
1. Де шукати ідеї для назв, коли «все вже зайнято»
Авторка матеріалу починає з дуже прикладної задачі: потрібно придумати нові імена для класів, функцій, токенів, а в голові крутяться лише кілька звичних слів. Для виходу з цього кола пропонується ресурс Classnames.
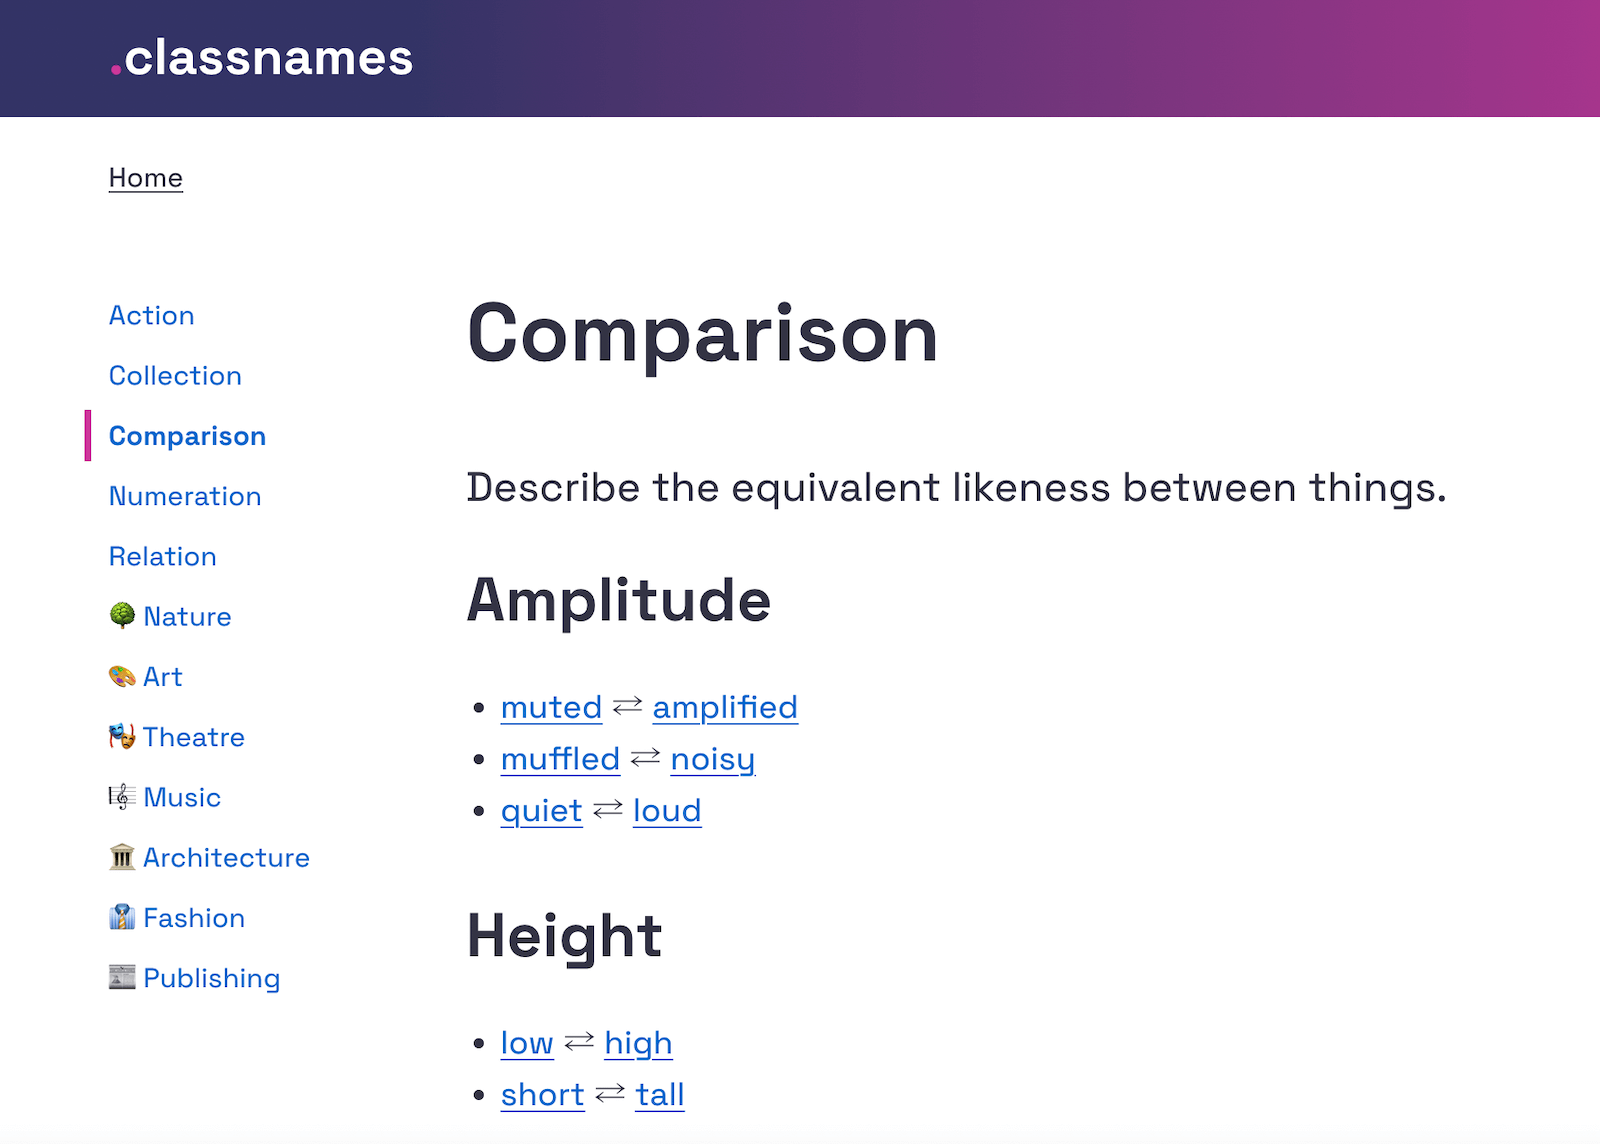
Classnames дає тематичні списки слів, які можна використовувати як будівельний матеріал для назв:
- слова про поведінку (рух, зміна стану, взаємодію);
- слова про схожість і відмінності, порядок, групування, асоціації;
- тематики, які зазвичай не асоціюються з кодом: природа, театр, музика, архітектура, мода, видавнича справа.
Практична користь тут не в «креативних» назвах самих по собі, а в тому, що ви швидко отримуєте набір словників, з яких можна зібрати свою нотацію: наприклад, послідовно використовувати лексику про рух для анімаційних state-класів, а архітектурні терміни — для структурних контейнерів.
2. Як не зламати систему назв на рівні шарів і компонентів
Javier Cuello у своїх guidelines з неймінгу формулює критерії «гарного імені» для шарів, груп і компонентів у дизайні.
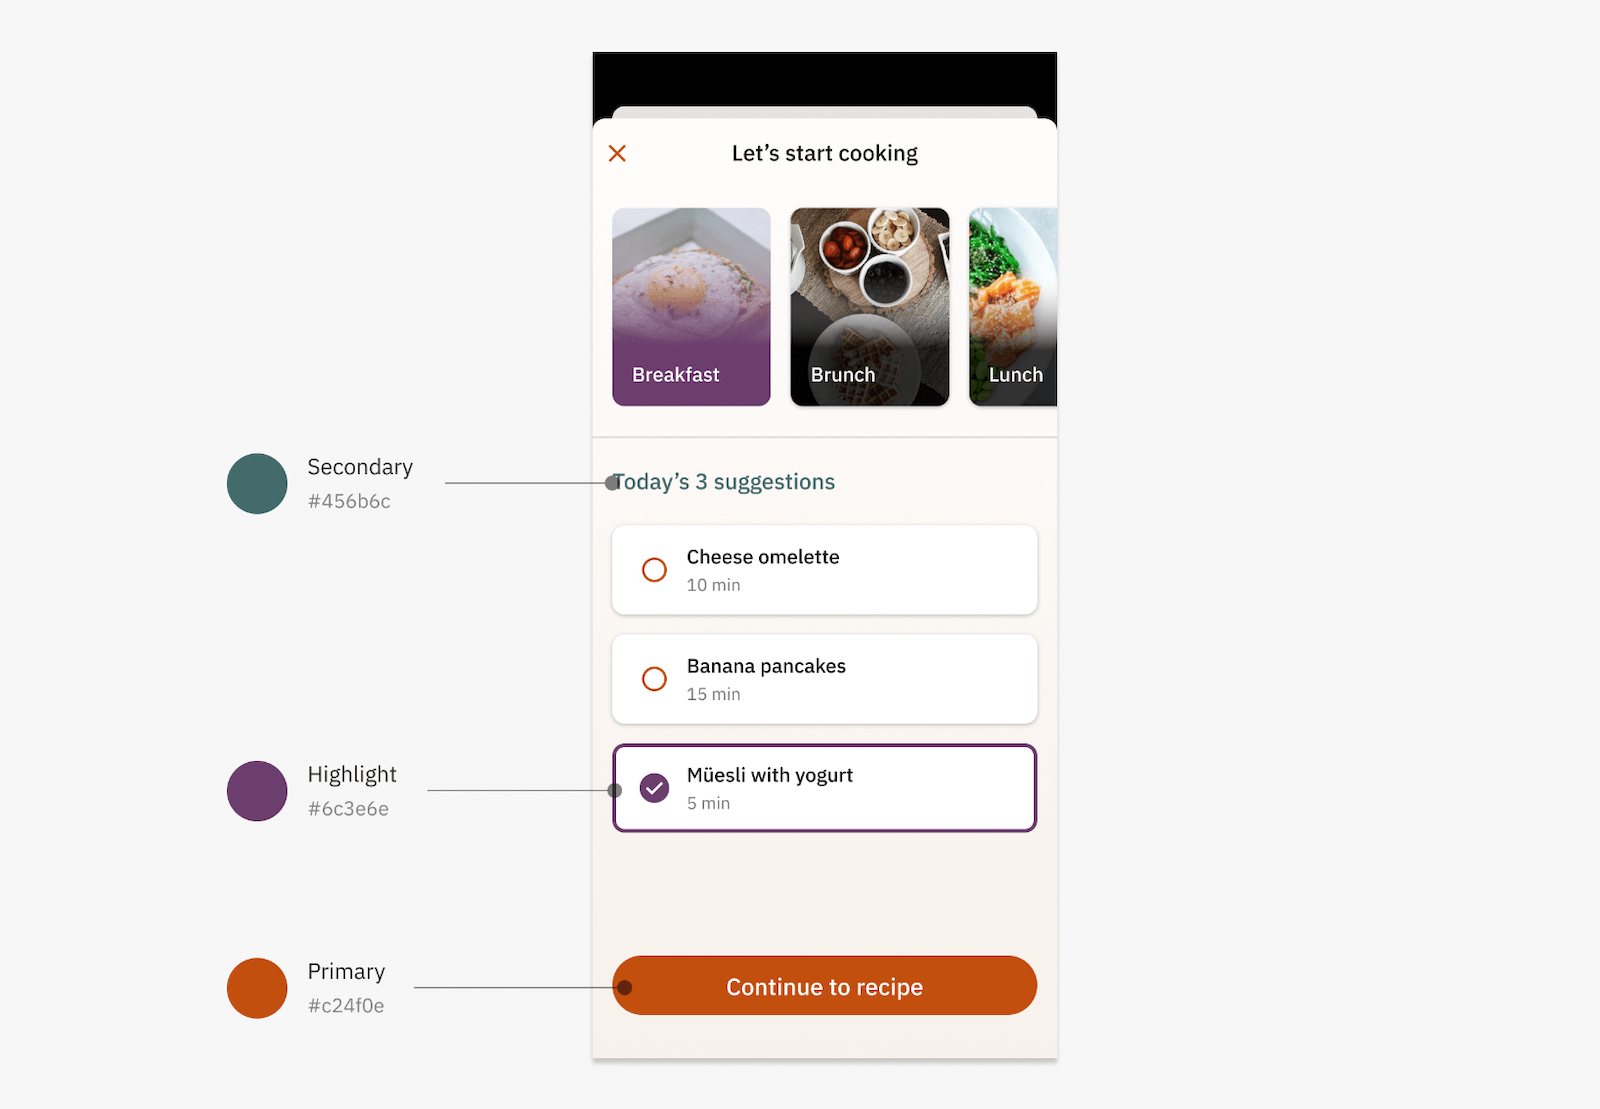
Основні принципи, які він виділяє:
- Логічна структура — назва підкоряється узгодженому патерну, а не вигадується щоразу наново. Наприклад, pattern типу
[тип] / [роль] / [стан]. - Стислість — короткі імена легше читати в списках шарів і в коді, менше шансів на помилки при введенні.
- Зрозумілість для всієї команди — використовуються терміни, які вже прийняті всередині продукту, а не унікальний жаргон окремої людини.
- Відв'язка від чисто візуальних властивостей — уникати назв на кшталт
button-blue, якщо це не специфічний бренд-стиль. Краще фіксувати роль або значення:button-primary,alert-success.
Javier розділяє окремі правила для різних сутностей:
- для розмірів — узгоджена шкала (наприклад,
xs/s/m/l/xlабо числові степи), - для кольорів — відокремлення «сирих» (brand/primitives) від семантичних (success, warning),
- для груп/шарів — послідовний порядок частин назви, щоб сортування за алфавітом давало логічні блоки.
Корисний практичний крок: домовитися в команді про 1-2 шаблони назв на кожен тип сутності (layout, компонент, токен, state) і описати їх в одному документі, а не в пам'яті кількох людей.
3. Playbook з неймінгу дизайн-токенів: від структури до воркшопів
Для тих, хто саме будує або переробляє систему дизайн-токенів, Romina Kavcic зробила інтерактивний Design Tokens Naming Playbook. Це не просто стаття, а майданчик для експериментів зі структурами назв.
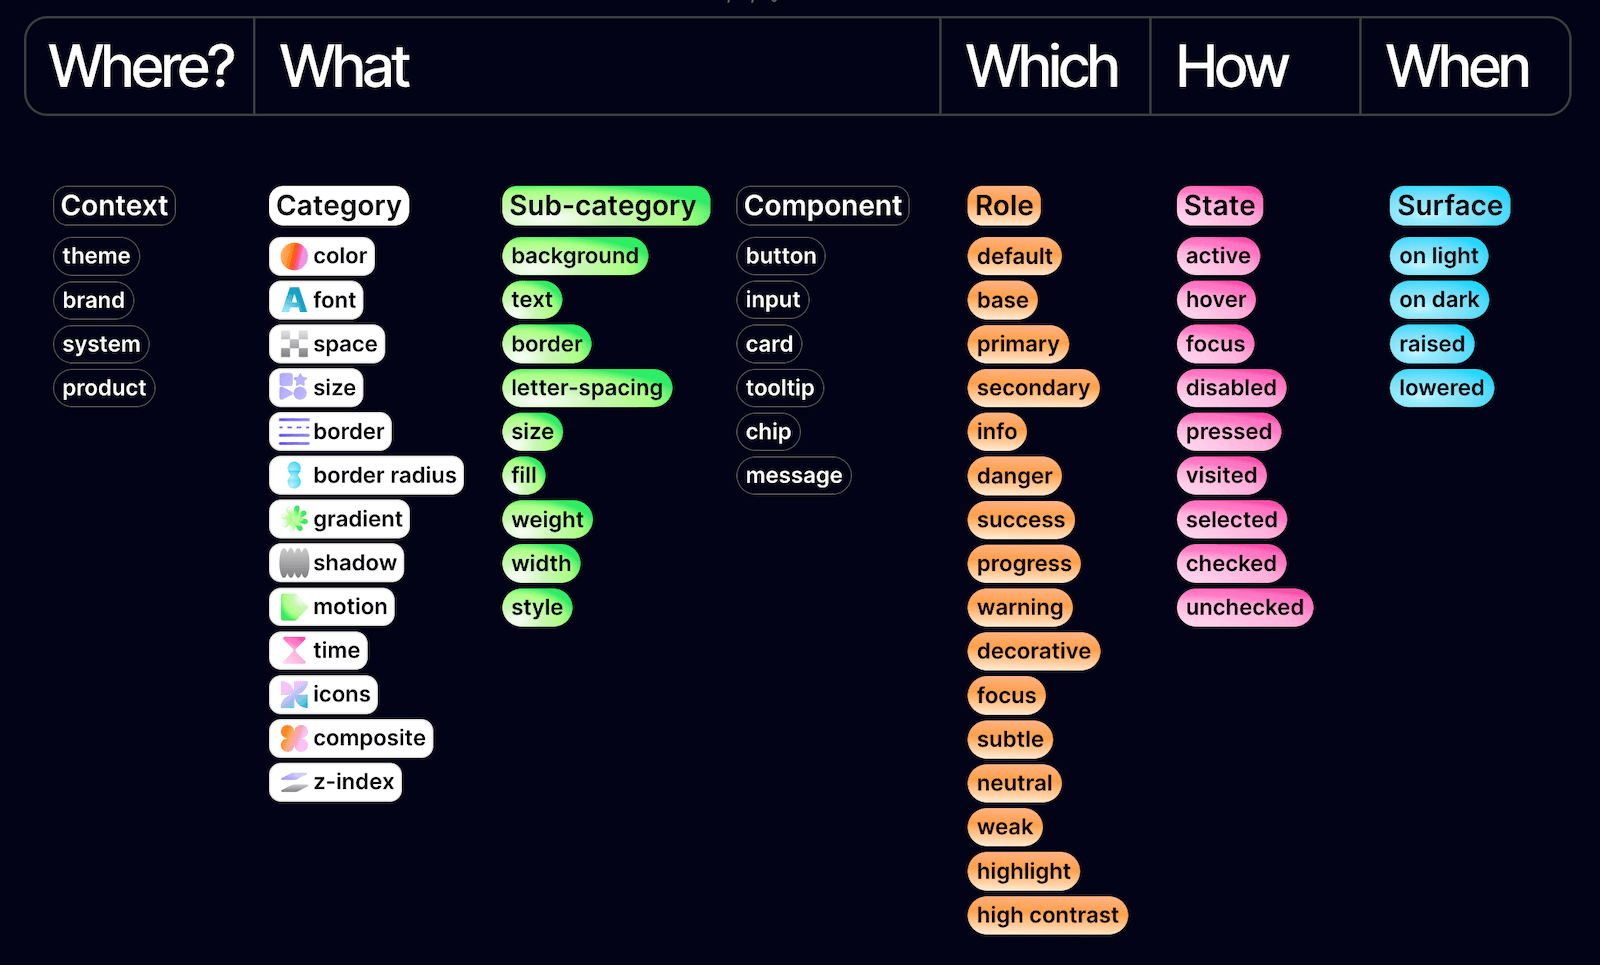
Playbook охоплює кілька напрямів:
- Підходи до структури назви — як збирати повне ім'я токена з «частин» (тип, роль, платформа, стан, модифікатор), щоб воно було одночасно уніфікованим і пошуковим.
- Пошукові бази — як організувати дані про токени так, щоб можна було швидко знаходити всі значення для конкретної ролі, теми або платформи.
- Неймінг-воркшопи — як залучити команду до вибору словника і патернів назв, а не спускати схему зверху без обговорення.
- Автоматизація — які частини роботи можна винести в скрипти або інструменти, щоб не перейменовувати вручну сотні токенів.
Ключовий елемент Playbook — naming playground: можна перетягувати блоки імен, збираючи варіанти структур для різних типів токенів, а потім перевіряти, як це виглядає на масиві даних.
Окремо є Figma-шаблон, де всі категорії токенів оформлені як компоненти — це дає можливість буквально «приміряти» різні схеми назв на реальні кейси вашої дизайн-системи.
4. Гнучка таксономія токенів: кейс Intuit
Команда Intuit (Mailchimp, QuickBooks, TurboTax, Mint) зіткнулася з типовою складною задачею: попередня система токенів перестала масштабуватися на різні продукти і бренди. Для вирішення Nate Baldwin описує кейс створення нової таксономії.
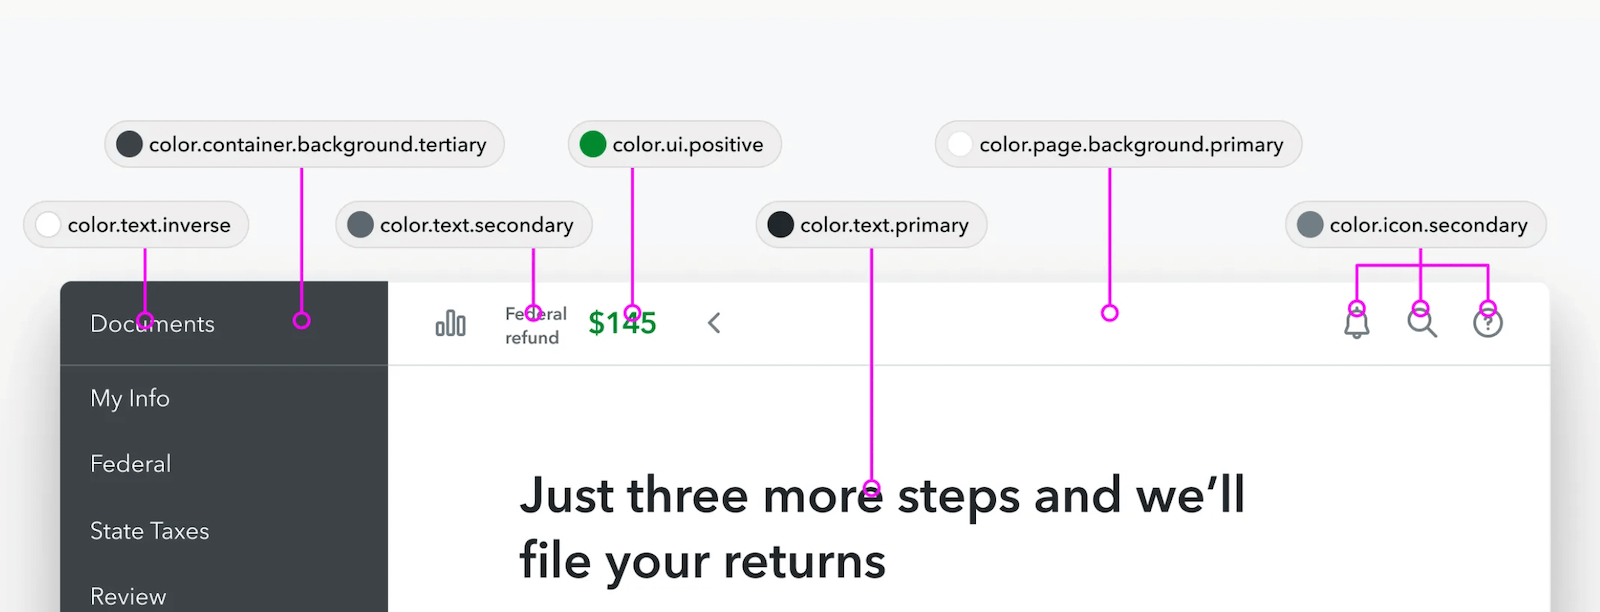
У фокусі кейсу — декілька проблем старої системи (за описом автора):
- тісна прив'язка до конкретних тем і брендів, через що повторно використовувати токени між продуктами було важко;
- непрозорі імена, з яких не зрозуміло, що саме означає токен і де використовується;
- ускладнене додавання нових продуктів і варіантів теми.
Команда сформулювала критерії для нової системи (описані Nate Baldwin):
- гнучкість для багатьох продуктів і платформ;
- відокремлення рівнів (brand, primitives, semantic тощо);
- можливість еволюції без тотальних перейменувань.
Результат — багаторівнева таксономія, яка виходить за межі однієї бренд-теми і служить спільним фундаментом для цілої екосистеми продуктів. З цього кейсу можна взяти методологію: спочатку чесно зафіксувати болі поточної схеми, потім прописати жорсткі критерії до нової, а вже під них підбирати структуру назв.
5. Як наводити логіку в назвах кольорів
Кольори — одна з найскладніших сфер неймінгу, бо сприйняття завжди трохи суб'єктивне. У Adobe цю задачу вирішують у масштабі великої дизайн-системи Spectrum. Jess Satell описує підхід до назв кольорів у цій системі.
Ключовий принцип Spectrum:
- назва кольору = родина кольору (наприклад,
blue,gray) + числовий рівень яскравості (шкала 50-900).
Це дає одразу кілька переваг, які зазначає авторка:
- логічність для різних ролей у команді — і дизайнери, і розробники швидко орієнтуються в послідовній шкалі;
- масштабованість — можна вставляти додаткові значення, не ламаючи загальну нотацію (наприклад, додати
blue-350між300і400, якщо це дозволяє внутрішня домовленість); - гнучкість при темізації — та сама семантика (наприклад,
color-background-primary) може посилатися на різніblue-Nу різних темах.
Для ситуацій, коли потрібно дати «людську» назву кольорам з картинки, авторка матеріалу звертає увагу на Color Parrot — Twitter-бот, який у відповідь на згадку повертає палітру й назви кольорів із зображення. Це не вирішує завдання таксономії в дизайн-системі, але корисно для пошуку початкових референсів або описових назв.
6. Як зрозуміти, «як це називають інші»: галерея компонентів
Ще один частий кейс — ви вигадали новий компонент або варіацію, але не впевнені, як його логічно назвати. Iain Bean зібрав для цього Component Gallery.
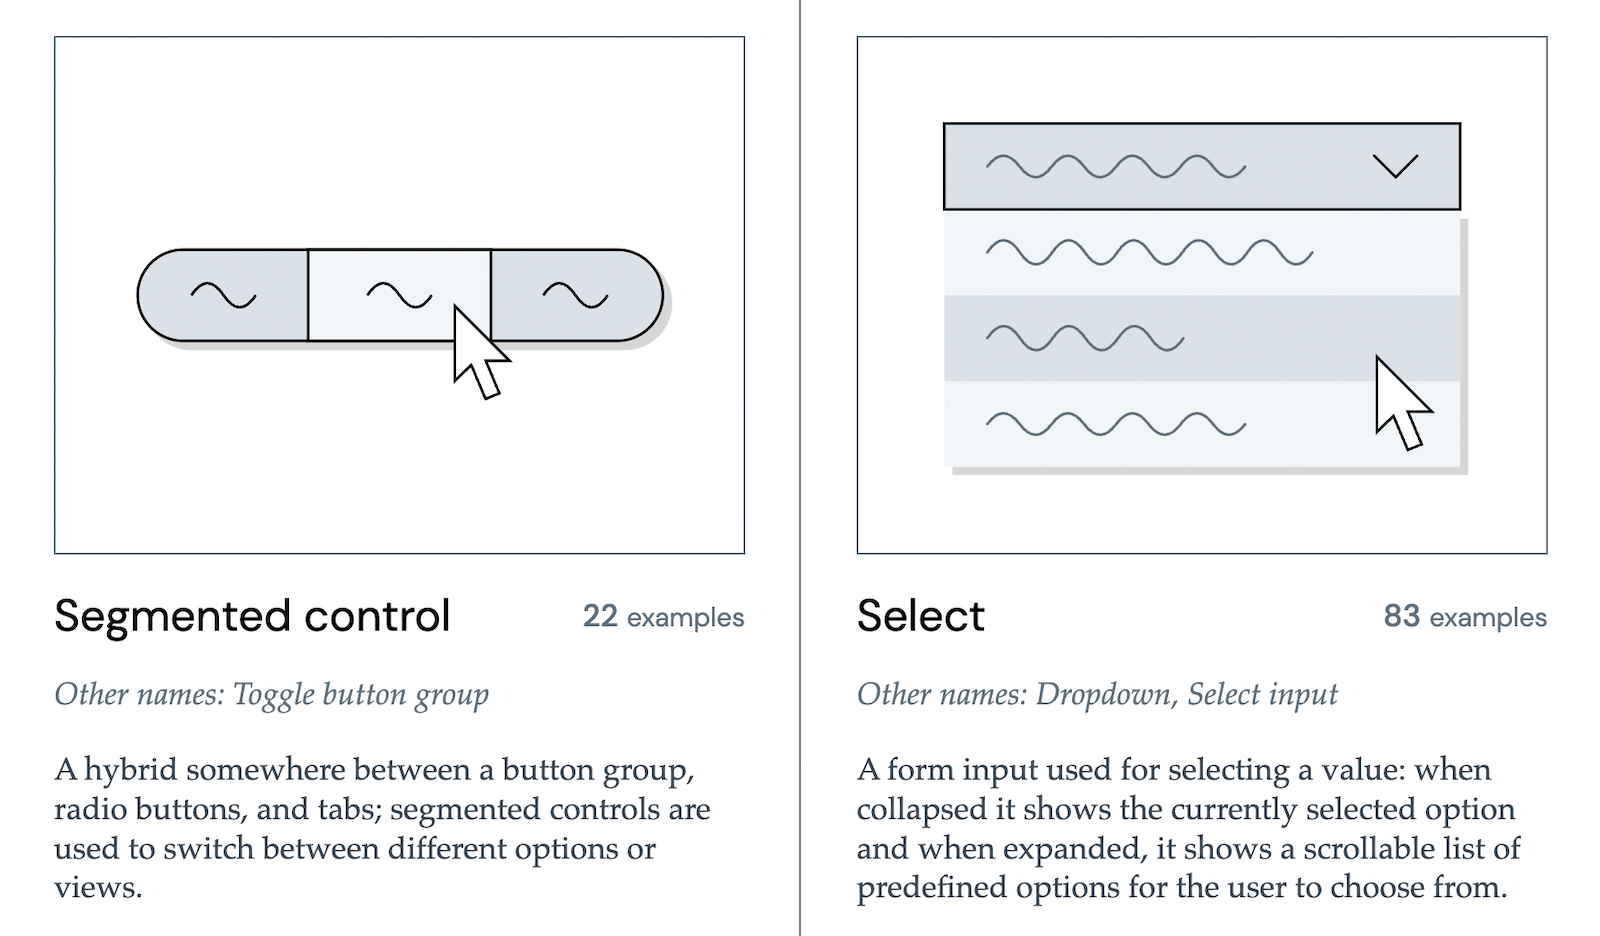
Що дає ця галерея:
- приклади більш ніж 50 UI-компонентів із реальних дизайн-систем;
- альтернативні назви, під якими той самий компонент зустрічається в інших системах;
- контекст використання — як компоненти виглядають і де застосовуються.
Практичний сценарій: перед тим як зафіксувати свою назву, варто перевірити Component Gallery і подивитись, як подібні речі вже названі в публічних системах. Це не гарантія «єдиного вірного» варіанту, але допомагає не вигадувати терміни, які будуть суперечити звичним для індустрії.
7. Карта таксономії змінних для мультибрендової системи
Vodafone UK Design System команда оприлюднила Variables Taxonomy Map — наочну схему того, як вони організовують змінні/токени в багатобрендовій та мультитемній системі.
У центрі цієї мапи — розкладання токена на рівні й колекції, які потрібні, щоб:
- підтримувати різні бренди й теми;
- розвести «сирі» значення (brand, primitives) і семантичні (наприклад,
text-primary,surface-elevated); - зрозуміти шлях токена від бренду до конкретної сторінки.
У схемі виділяються щонайменше чотири колекції, пов'язані між собою — від рівня бренду й примітивів до семантики та «сторінкових» змінних. Згідно з описом, мапа спирається на роботу Nathan Curtis про неймінг дизайн-токенів і служить загальною мовою: за однією назвою можна зробити припущення, що саме означає токен і де він використовується.
Якщо у вас вже є багаторівнева система токенів, корисна вправа — накреслити свою «карту» на кшталт Vodafone Map і перевірити, чи справді всі назви узгоджені між рівнями.
8. Інвентар імен токенів із синхронізацією у Figma
Другий інструмент від Romina Kavcic — Design Token Names Inventory у вигляді Google Spreadsheet. Він орієнтований не стільки на вибір конкретних назв, скільки на керування всією системою неймінгу.
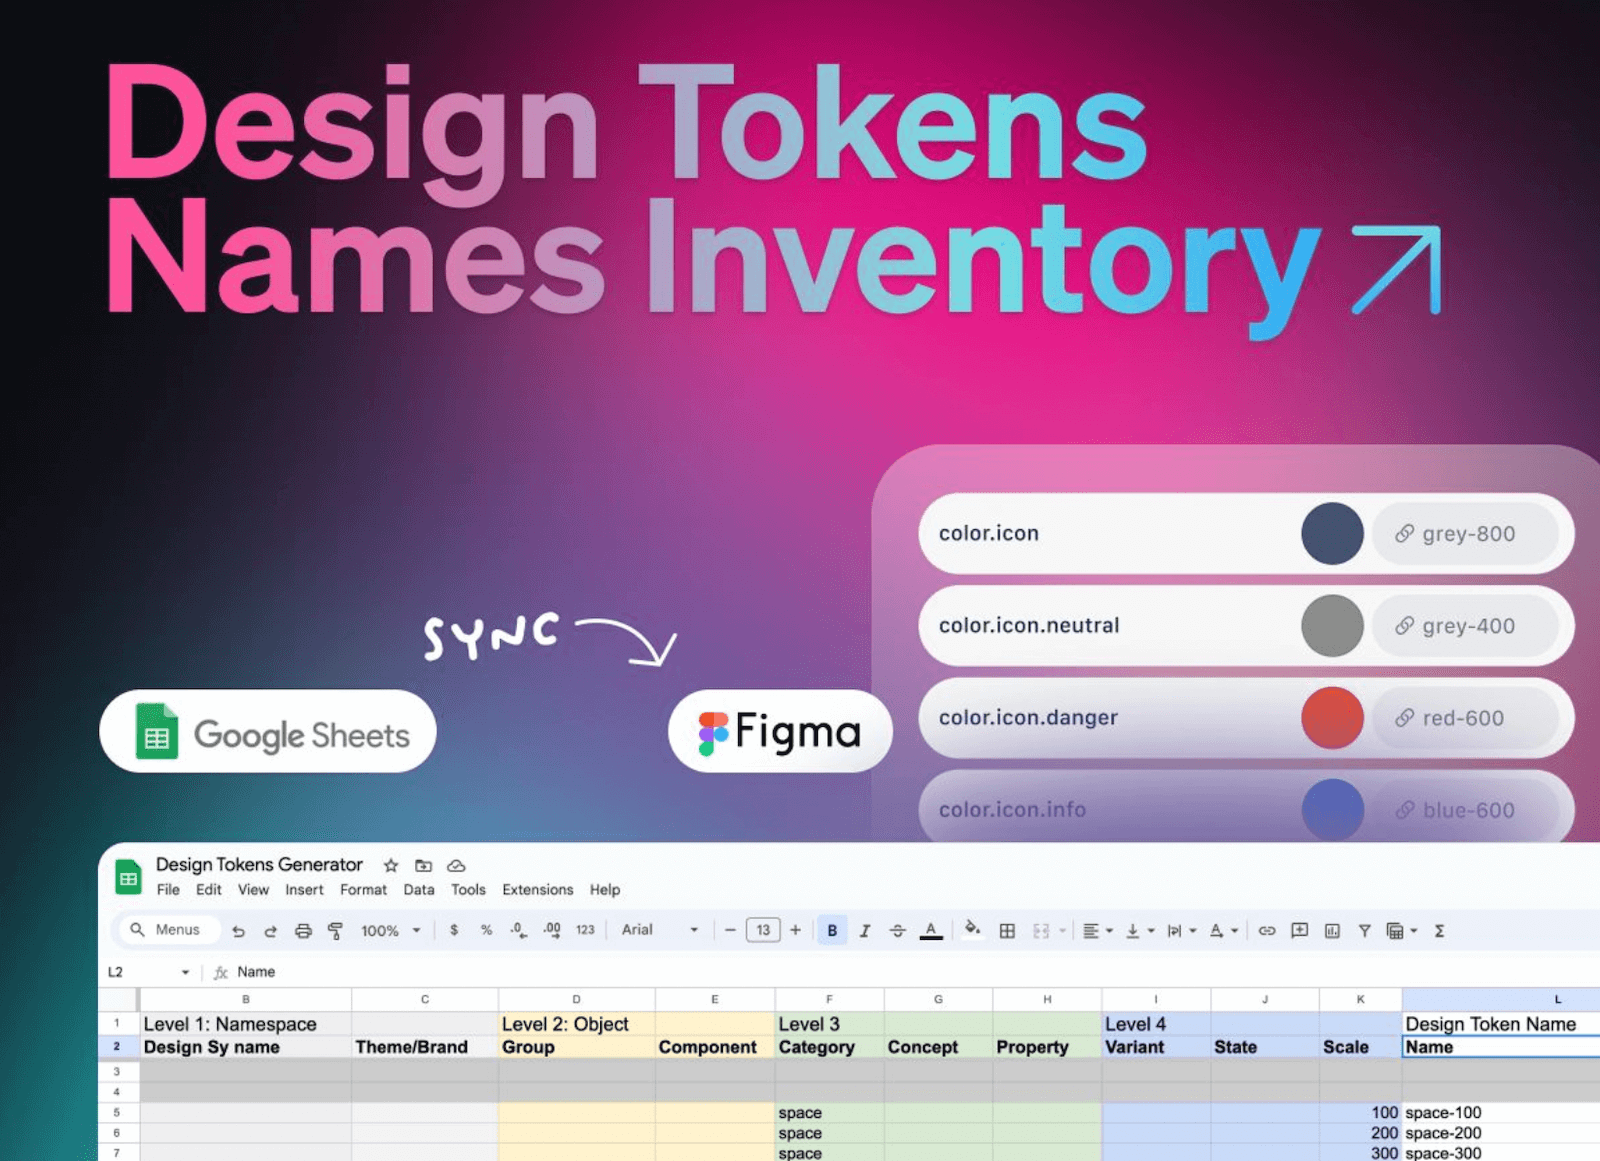
Особливості цієї таблиці:
- чотирирівнева структура, яка дає «огляд зверху» по всіх токенах;
- можливість додавати рядки, теми й режими без втрати загальної картини;
- фільтрація токенів за різними ознаками (тип, рівень, тема тощо).
Головна сила інструмента — інтеграція:
- через Google Spreadsheets plugin або
- Kernel plugin
таблиця синхронізується з Figma. За описом Romina, зміни в неймінгу вносяться один раз у Spreadsheet і автоматично відображаються у Figma, що економить багато ручної роботи і зменшує ризик розсинхрону між документацією й реальними змінними.
9. З чого почати впроваджувати ці підходи у своєму проєкті
Матеріал збирає різні інструменти й кейси, але їх легко розкласти в послідовність дій, яку можна адаптувати під будь-яку дизайн-систему.
- Зібрати словник і приклади.
Переглянути Classnames і Component Gallery, виписати релевантні терміни для ваших компонентів і патернів. - Домовитися про базові принципи імен.
Спираючись на рекомендації Javier Cuello, зафіксувати: структуру назв (патерни), заборони (наприклад, не прив'язуватися до кольору), шкали розмірів і яскравостей. - Спроєктувати таксономію токенів.
Подивитися приклади Intuit і Vodafone, вирішити, які рівні потрібні саме вам (brand, primitives, semantic, alias, page-level) і як це має відбитися в іменах. - Окремо пропрацювати кольори.
Визначити, чи підходить вам підхід «родина + яскравість», як у Spectrum, чи потрібна інша шкала. Розділити назви родин від семантичних ролей. - Завести єдине джерело правди.
Налаштувати таблицю на кшталт Design Token Names Inventory і, за потреби, зв'язати її з Figma через доступні плагіни. - Провести невеликий воркшоп.
Використати ідеї Romina Kavcic про naming workshops: зібрати дизайнерів і розробників, пройтися по критичних групах токенів/компонентів і разом узгодити суперечливі місця.
Для глибшого занурення в теми назв токенів і змінних автори згадують також добірку Figma-кітів і ресурсів, яку Vitaly Friedman опублікував у LinkedIn: посилання на підбірку. Це корисний наступний крок, коли базові принципи вже визначені, а хочеться подивитися на реальні реалізації різних команд.
Джерело: Cosima Mielke – Smashing Magazine. Дата оригіналу: 2024-05-23.