Архівний матеріал: розбір публікації від 2025-05-12. Назви функцій, інтерфейс, можливості плагінів і умови доступу наведені в контексті того часу.
У цьому розборі розглянемо підхід команди SAS Filament Design System (автори підходу — Rebecca Hemstad та Mark Malek), яка інтегрувала локалізацію в дизайн‑систему та Figma‑бібліотеки. Це не універсальний стандарт, а реальний робочий кейс великого продукту з глобальною аудиторією.
1. Вихідна проблема — дизайн лише англійською
Команда працює з дизайн‑системою Filament у Figma: дизайнери беруть бібліотеки компонентів і токенів, створюють детальні UX‑макети — майже завжди англійською. Для глобальної аудиторії це призводило до типових проблем:
- переповнення тексту при перекладі на «довші» мови (німецька тощо);
- зламані макети та відсутність гнучкого перенесення рядків;
- складнощі з правосторонніми (RTL) мовами;
- подальші usability‑проблеми вже в продуктах SAS.
Це змусило команду перенести локалізацію ближче до фундаменту дизайн‑системи — у дизайн‑токени та перемикачі режимів у Figma.
Локалізація проти інтернаціоналізації
Автори чітко розводять два рівні роботи:
- Localization (L10n) — адаптація під конкретну мову/регіон:
- переклад текстів;
- перебудова макетів під довші/коротші рядки;
- облік RTL‑мов, культурних і візуальних особливостей.
- Internationalization (I18n) — підготовка дизайну до багатомовності:
- використання плейсхолдерів замість «захардкожених» текстів;
- правильні constraints і auto‑layout для розширення/скорочення тексту;
- підтримка двонапрямного тексту (LTR/RTL).
Для дизайн‑системи це означає: не просто перекладати макети, а закладати гнучкість уже в токени, стилі й компоненти.
2. Як організувати токени під теми, щільність та мови
2.1. Базова система токенів і «семантичний» рефакторинг
У SAS дизайн‑токени зберігаються в JSON‑файлах у репозиторії GitHub у застосунку «Token Depot». Трансформація в Figma‑бібліотеки відбувається через плагін Tokens Studio (pro), а самі токени фактично відповідають Figma Variables. Значення токенів напряму співпадають із CSS‑значеннями.
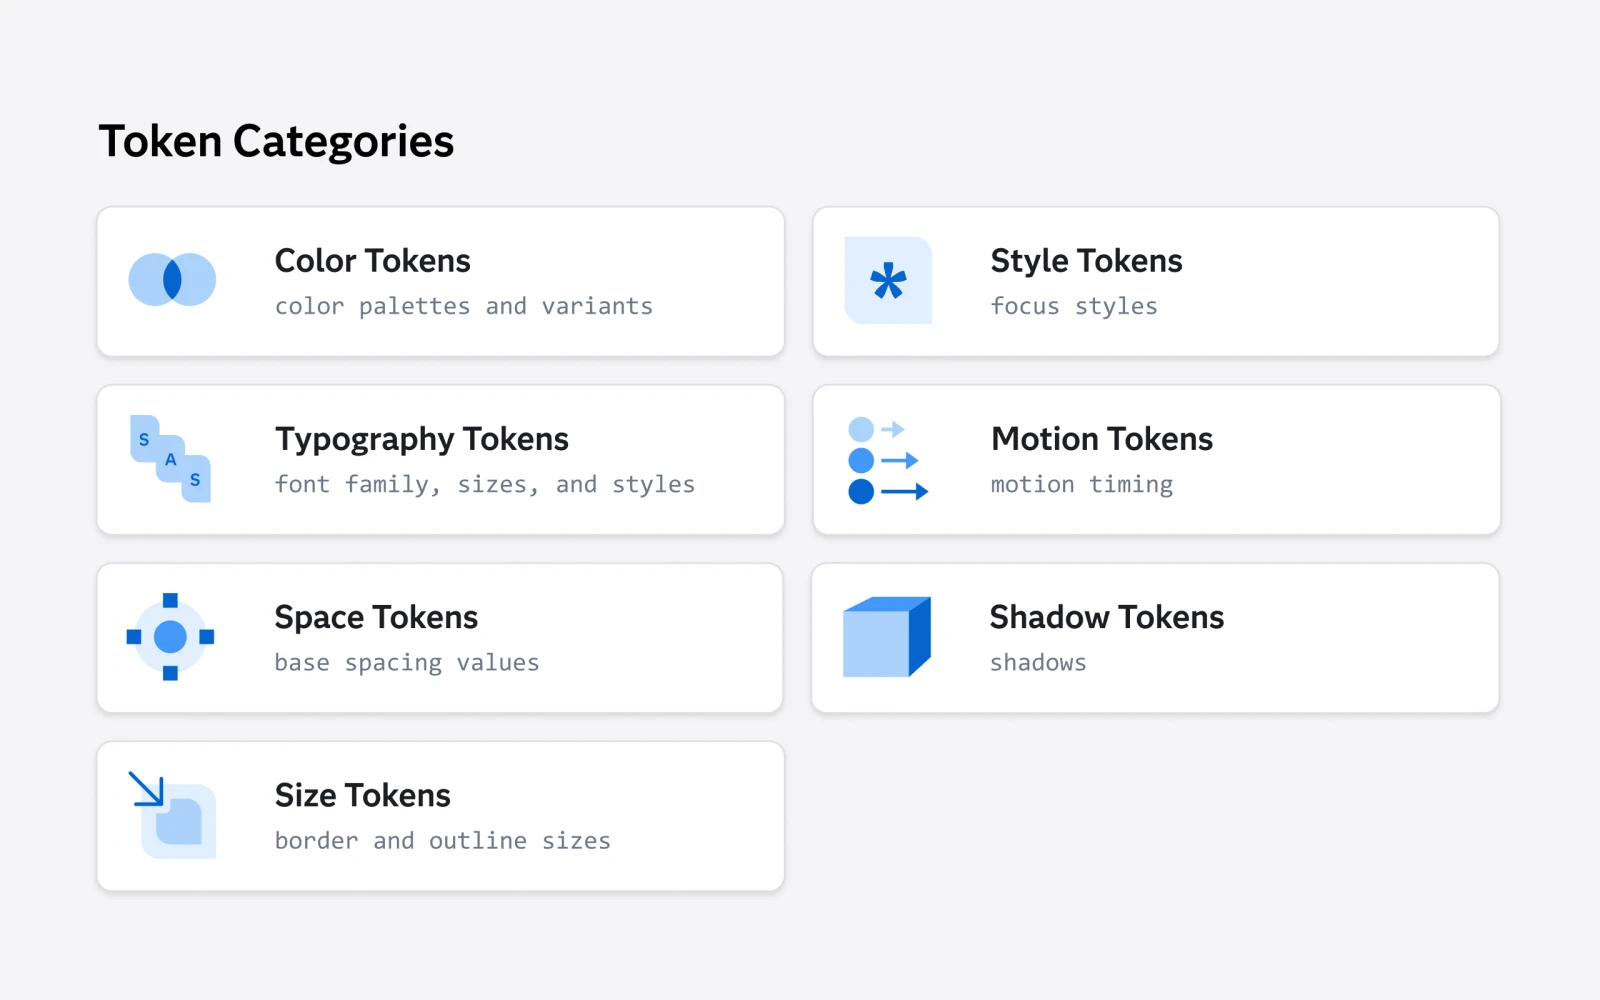
Ще у 2022 році команда провела велике перейменування токенів у бік семантики (не «blue‑500», а «action‑primary», тощо) та структурувала їх за типами:
- Color (brand, base colors);
- Typography;
- Space;
- Size;
- Style;
- Motion;
- Shadow.
Початково основний фокус був лише на перемиканні тем, тому JSON‑структура виглядала так:
- core — значення, незалежні від теми чи бренду;
- brand — по три JSON на бренд (один на тему), англійська за замовчуванням;
- languages — файли‑override для інших локалей, які змінюють окремі типографічні токени.
Локалізаційні overrides спочатку були мінімальними — головно типографіка. Наприклад, для CJK‑мов (китайська, японська, корейська) часто немає справжнього «bold», тож замість font-weight: 700 застосовували 400, а також змінювали font-family, letter‑spacing, font‑style, font‑variant.
2.2. Додавання щільності (density) і перегрупування токенів
Коли в продуктах з'явилося перемикання щільності інтерфейсу (density), це стало тригером переглянути, які саме токени залежать від теми/щільності/мови.
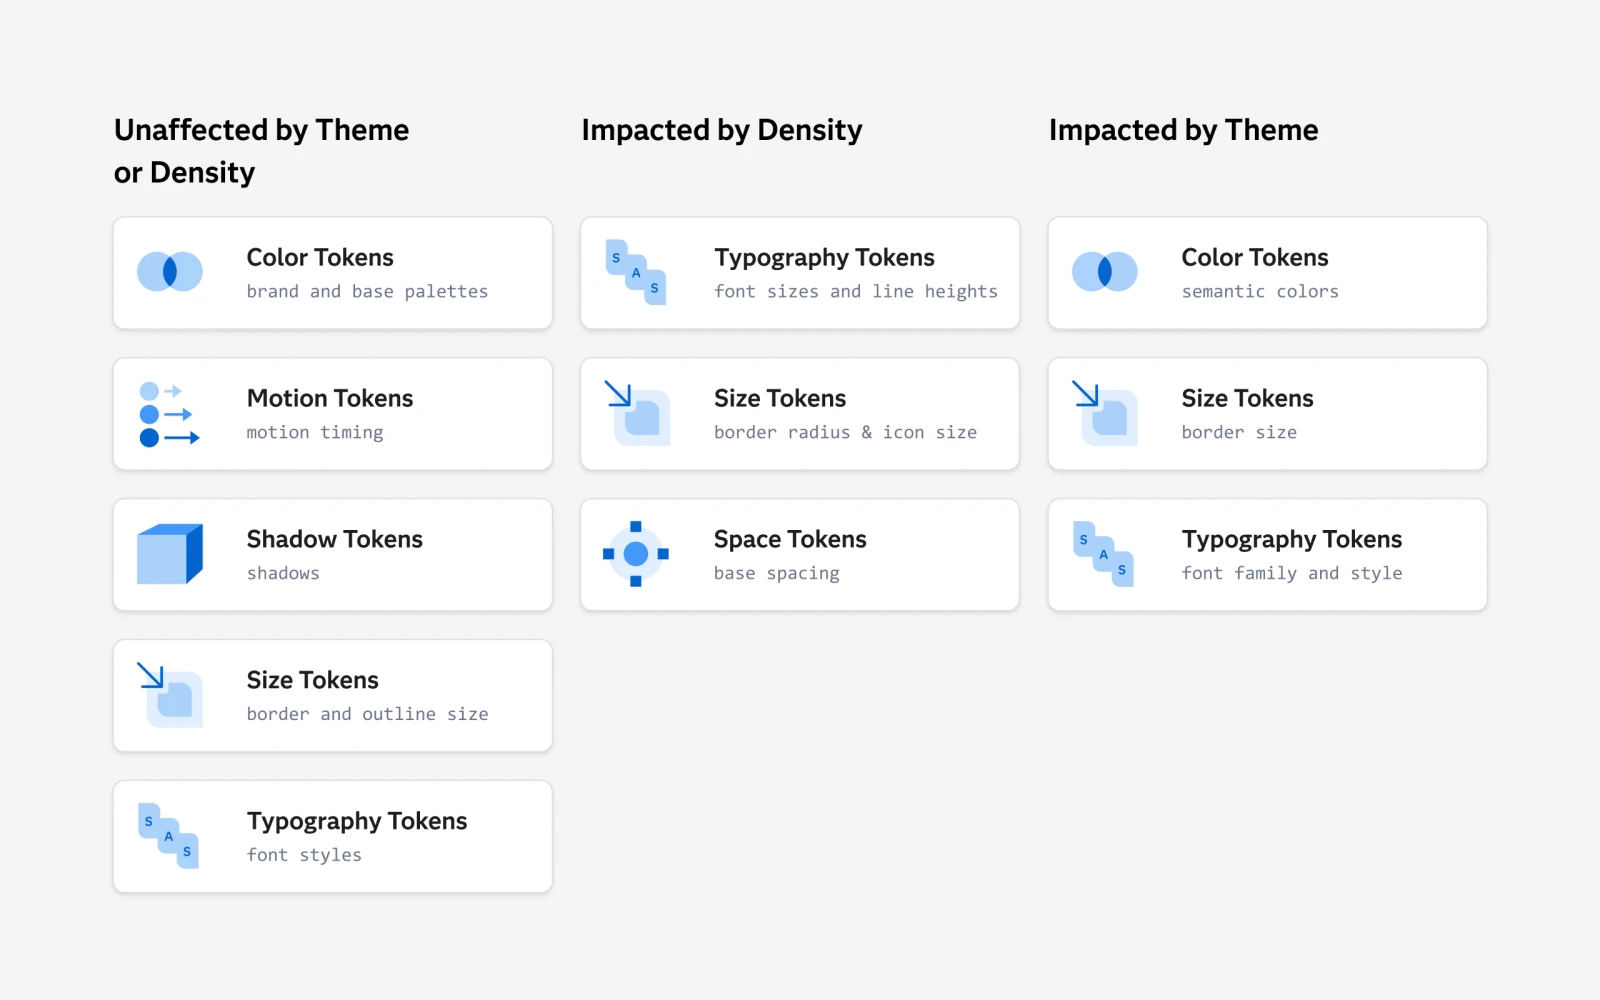
Автори склали карту впливу:
- Не залежать від теми та щільності: частина кольорів, motion, shadow, частина size, базові типографічні параметри (base font size, letter/word spacing, overflow‑стилі).
- Залежать від щільності: font‑size, line‑height, spacing, border‑radius, icon‑sizes, частина size.
- Залежать від теми: палітри для різних ролей (action, text, status тощо), деякі розміри, font‑family, focus‑стилі.
До попередніх мовних змін додалися щільнісні — тепер локалі впливали ще й на:
- font‑size;
- icon‑size;
- line‑height;
- spacing;
- border‑radius.
Команда перерахувала типографічну шкалу для всіх комбінацій «локаль × щільність» та на базі цього вирішила перебудувати JSON‑файли.
2.3. Реструктуризація JSON: від локалей до мовних категорій
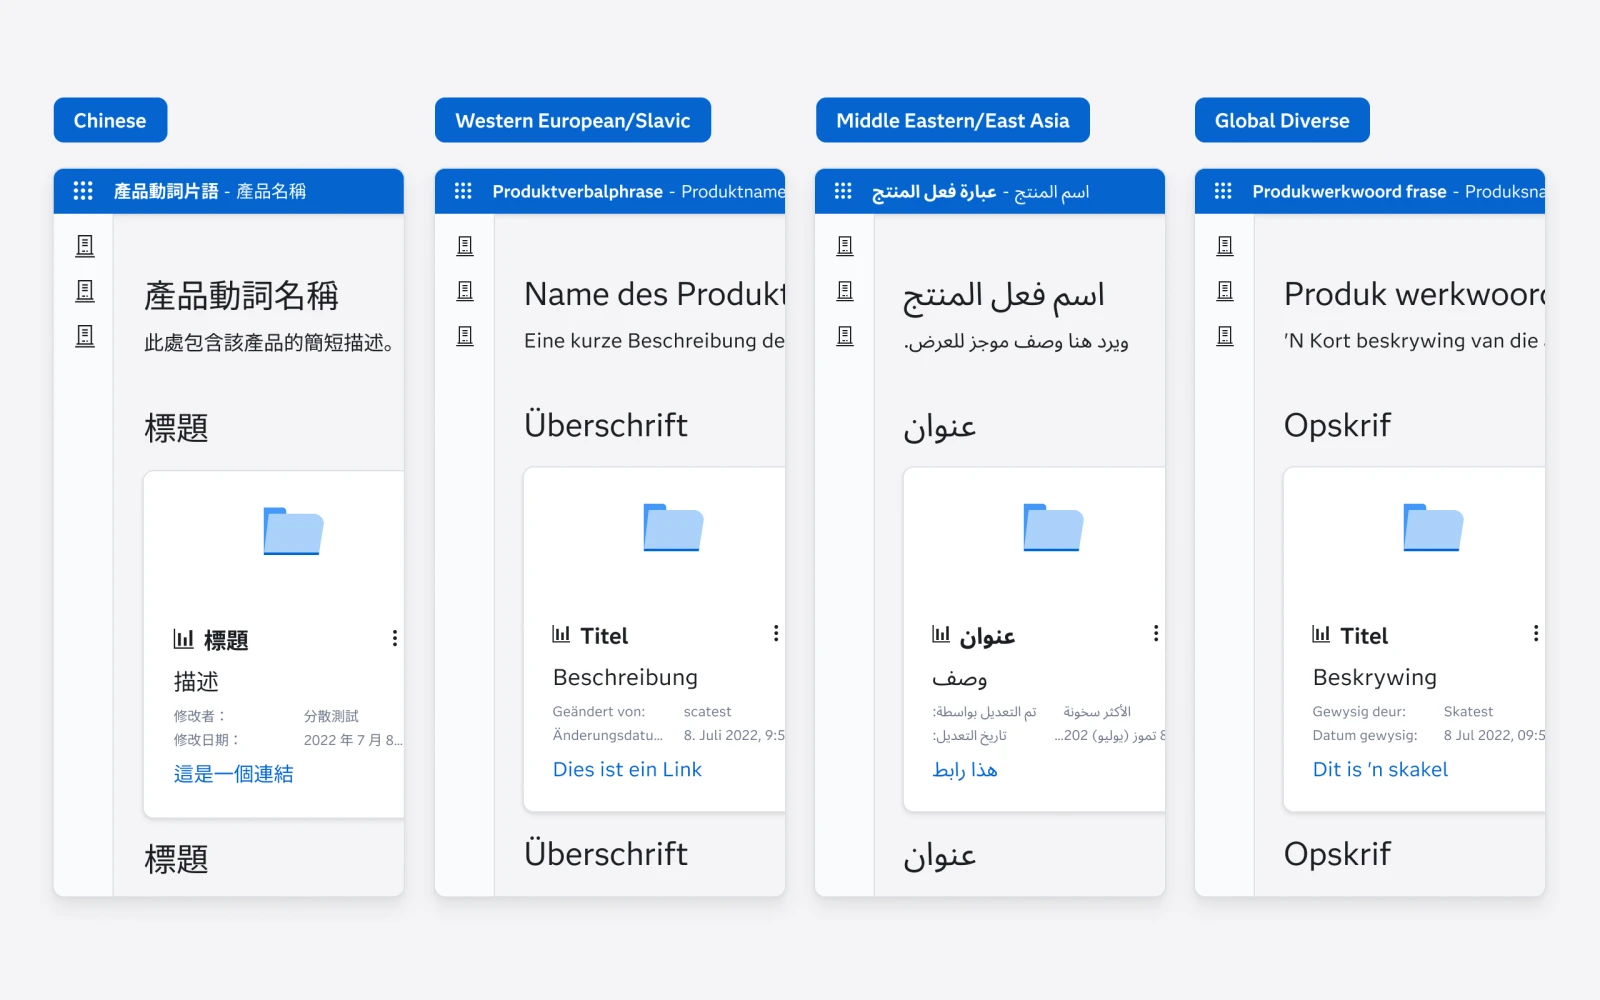
Після обговорення з фронтенд‑командою стало очевидно: надто велика кількість JSON‑файлів сповільнює збірку та створює ґрунт для помилок. Замість структури «окрема локаль × окрема щільність» ввели мовні категорії і мінімізували файли:
- Western European and Slavic
Польська, англійська, французька, німецька, іспанська. - Chinese languages
Спрощене та традиційне письмо. - Middle Eastern and East Asian
Арабська, іврит, японська, корейська, тайська, в’єтнамська. - Global diverse
Африка, Південна Азія, Тихоокеанський регіон, корінні мови, уральські й тюркські групи.
Для кожної категорії створили по одному JSON‑файлу на кожен рівень щільності із такими токенами:
- font‑size;
- icon‑size;
- line‑height;
- spacing;
- border‑radius.
Окремо додали папку з JSON‑файлами по локалях, які override‑ять те, що не можна узагальнити через категорії (наприклад, конкретні font-family стеки).
3. Інтеграція з Figma: обмеження Tokens Studio і variables
3.1. Перехід на Tokens Studio 2.0 і «ламкий» імпорт
Після реструктуризації JSON команда очікувала «просто» підключити нові токени як Figma variables, разом з типографікою. Натомість оновлення Tokens Studio до версії 2.0 змінило звичний процес:
- імпорт JSON вже не поводився, як раніше;
- файли
$metadata.jsonта$themes.jsonнекоректно перезаписувалися; - у Figma виникали дублікати collections при експорті variables.
Щоб стабілізувати процес, автори видаляли старі $metadata.json та $themes.json з репозиторію перед черговим pull у плагін, а після експорту все одно мусили вручну чистити зайві collections у Figma.
3.2. Типографічні variables: розрив між CSS і Figma
Ключова проблема виявилась у тому, що типографічні токени не вкладалися в модель Figma Variables:
- у Figma «auto» line‑height за замовчуванням — множник 1.2, тоді як команда орієнтується на WCAG‑мінімум 1.5;
- у токенах лінійні інтервали зберігалися як множники, що коректно для CSS (відсоток), але Figma не дозволяє використовувати відсоткові значення у variables;
- отримані з JSON назви й режими variables імпортувалися, але частина значень залишалася «порожньою».
Команда обрала компроміс: вручну прорахувала pixel‑значення line‑height для всіх розмірів шрифтів, мовних категорій і щільностей та ввела їх як локальні Figma variables, не пов’язані з токенами. Це дозволило коректно перемикати щільність і локалі, але коштом:
- сотень ручних змінних;
- ручного групування font‑size та line‑height у Figma styles;
- відсутності «єдиного джерела правди» між CSS‑токенами й Figma для лінійних інтервалів.
Приклади з кейсу:
- CJK‑локалі: base font size 16 px для medium/low density, 18 px для high.
- Western European & Slavic: 14 px для medium, 16 px для high, 12 px для low.
3.3. Додаткові розбіжності: line‑height, letter‑spacing і шрифтові стеки
- Figma vs web rendering
Figma візуально центрує текст у фреймі line‑height'ом, тоді як у CSS лінійний інтервал взаємодіє з box‑model складніше. З урахуванням майбутніх CSS‑властивостей типуleading-trimце створювало додаткові ручні доробки в макетах. - Letter‑spacing
У CSS значенняnormal— допустиме й часто бажане для локалей, але Figma вимагає числового значення. Через це «скинути» літерний інтервал до нормального значення змінною не виходило. - Font‑family stacks
Для вебу команда описує складні стеки, наприклад, для китайської:font-family-primary: 'AnovaUI', '微软雅黑体', 'Microsoft YaHei New', '微软雅黑', 'Microsoft Yahei', '宋体', 'SimSun', 'Helvetica Neue', 'Helvetica', 'Arial', sans-serif.
Початок стеку з латинського шрифту зберігає бренд для латинських символів, але у Figma реалістично попередній перегляд таких стеків відтворити складно — макети рендеряться тільки з AnovaUI, без системних підстановок.
4. «Примари» Figma: ghost variables та їх чистка
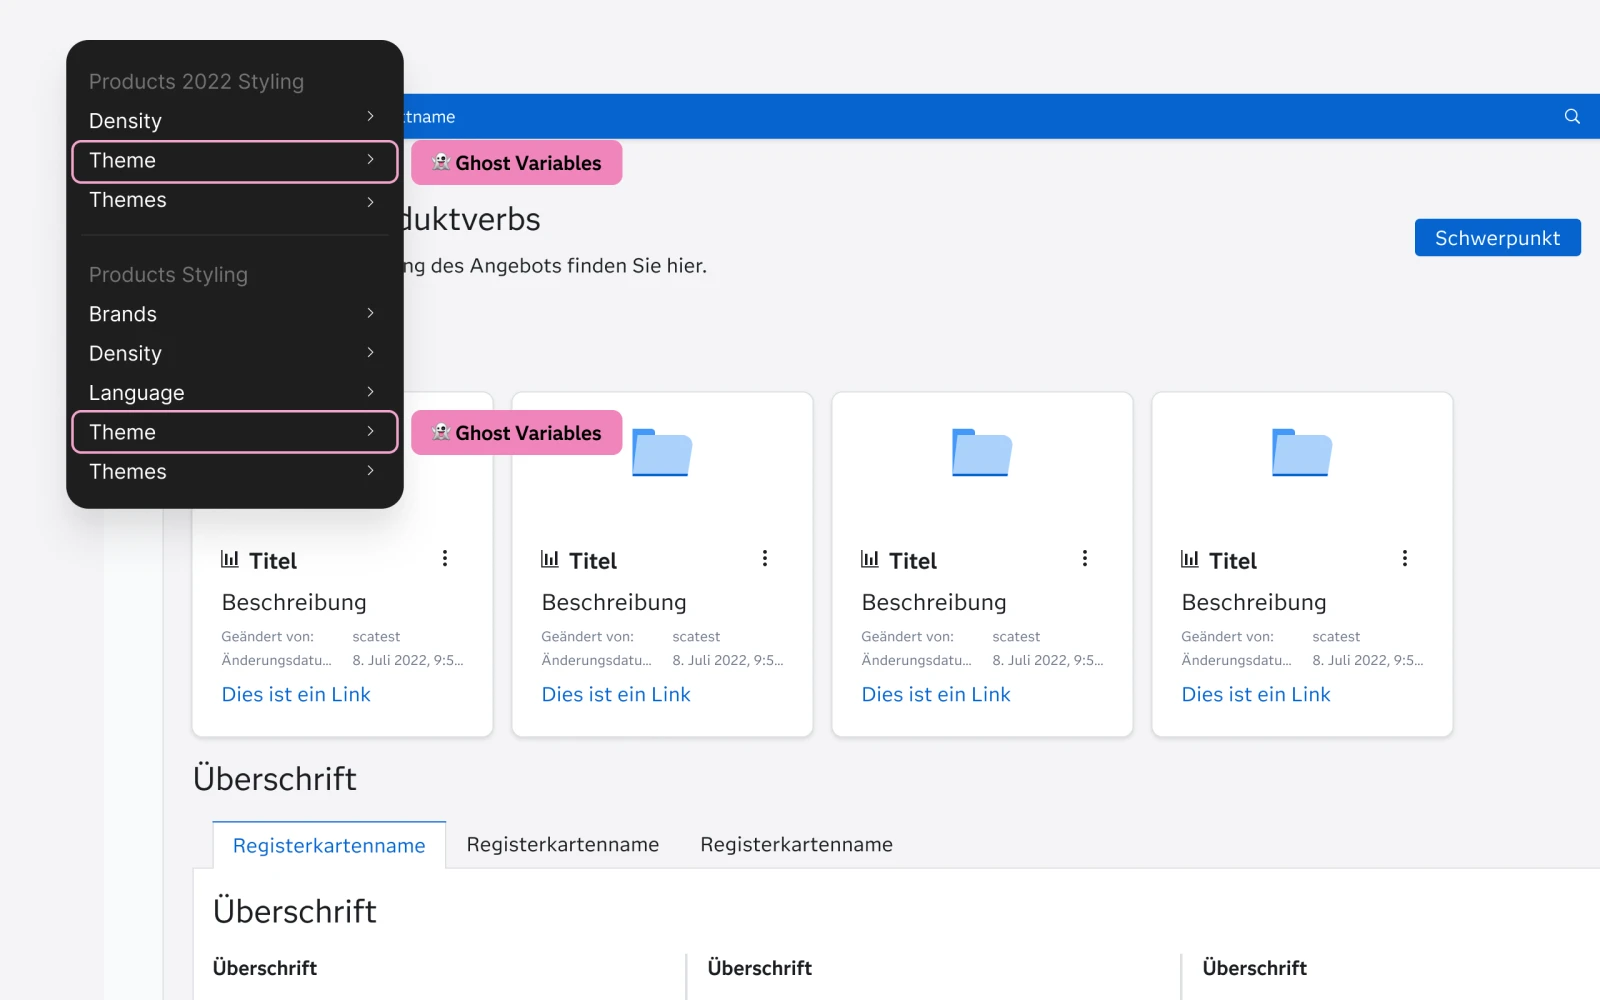
4.1. Що таке ghost variables і чим вони заважають
При багаторазових імпортах/видаленнях токенів у Figma з'являються ghost variables — змінні, які:
- відображаються у панелі Variables;
- більше не пов’язані ні з темами, ні з компонентами;
- часто залишаються через некоректний оверрайт метаданих або неповне видалення.
Вплив на роботу дизайнерів:
- засмічують список змінних — важко зрозуміти, що актуально;
- можуть випадково потрапити в макети, створюючи несумісні стилі;
- ускладнюють експорт/синхронізацію з репозиторієм токенів (дублікати, конфлікти);
- підвищують витрати часу на підтримку бібліотек.
4.2. Як команда SAS чистила ghost variables
Автори описують суто практичний підхід:
- перевірка компонентів у бібліотеці — перегляд, до яких змінних підключені текстові та інші шари;
- пошук «застарілих» посилань у компонентах та іконкових бібліотеках;
- прохід по layer panel і заміна значень через плагін Swap Variables — масове перепризначення на актуальні variables;
- лише після цього — видалення справді не використаних змінних.
Без цього кроку, за словами авторів, дизайнери не змогли б повноцінно використовувати режими перемикання теми, щільності та локалі в компонентах.
5. Налаштування символів Figma під багатомовність
5.1. Прив’язка типографіки до змінних
Щоб символи могли «перемикати мову», у всіх текстових шарах компонентів:
- призначили variables для font-family, font-size, line-height (де це було можливо);
- уникали фіксованих значень, які перешкоджають щільності й локалям.
Зберігати окремі текстові змінні для кожного рядка і кожної мови (English, Spanish, French тощо) команда визнала практично нереальним — через масштаб продуктів SAS. Замість цього для контенту використовують Figma‑плагін Translator:
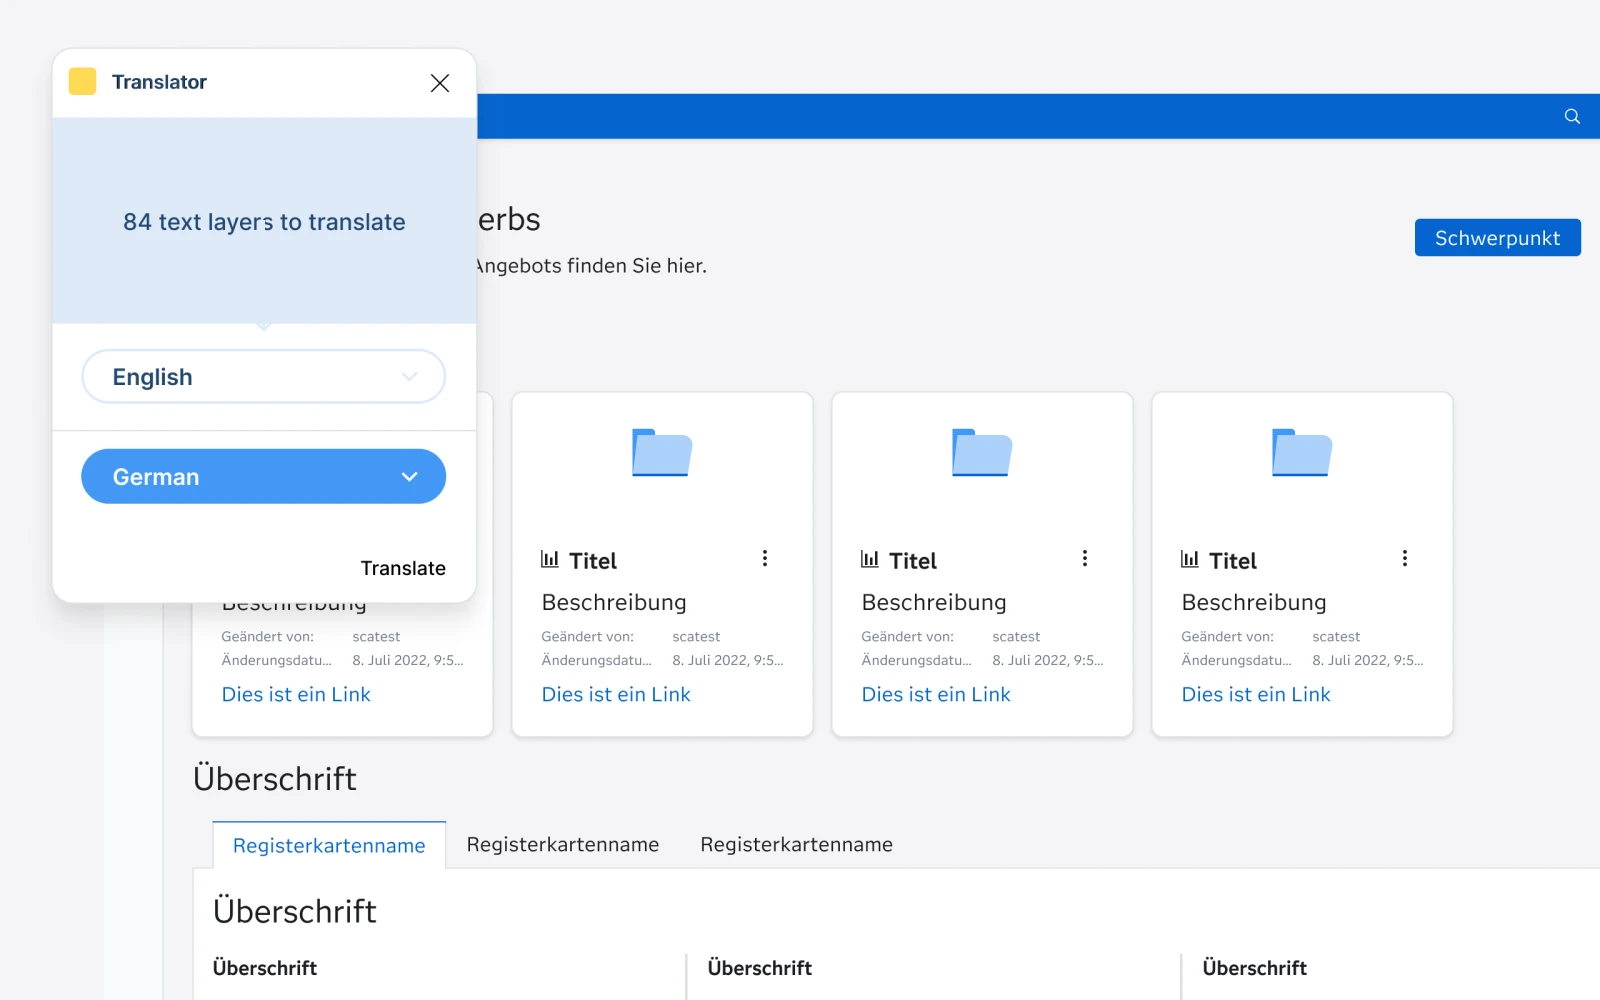
Після того як всі текстові шари прив’язали до нових типографічних змінних, плагін дозволив швидко «переключати» цілі екрани на іншу мову й шукати проблеми з версткою.
5.2. Авто‑layout проти поламаних переносів
Тестування локалізованих макетів виявило типові кейси:
- компонент не дозволяє перенесення рядка, коли з’являється надто довге німецьке слово;
- японський або інший компактний текст залишає «дірки» у сітці;
- фіксована ширина текстових контейнерів руйнує адаптивність.
Проблемні символи перевели на auto‑layout з гнучкими розмірами (де це було доречно). У результаті компоненти краще масштабуються по ширині, зберігаючи читабельність тексту для різних мов.
6. «Multilingual Design Cheat Sheet» для дизайнерів
Щоб дизайнери продуктів правильно використовували можливості системи, команда підготувала короткий гайд. Нижче — ключові практичні пункти, які можна адаптувати під інші дизайн‑системи.
6.1. Загальні принципи
- Проєктувати макети, які витримують текст з перенесенням, різну довжину рядків і RTL‑орієнтацію.
- Максимально рано підставляти реальний контент (або хоча б реалістичні переклади), а не Lorem Ipsum.
- Враховувати культурні очікування: образи, символи, приклади в інтерфейсі.
6.2. Текст і типографіка
- Використовувати шрифти дизайн‑системи (у кейсі — Filament), які вже перевірені на підтримку цільових мов.
- Уникати кастомних шрифтів без повноцінних накреслень (особливо для CJK‑писемностей).
- Лайфхак: планувати додатковий простір для «довгих» мов, наприклад, німецької чи фінської.
- Не фіксувати ширину текстових блоків без крайньої потреби — покладатися на auto‑layout.
- Використовувати змінні line‑height з токенів, якщо такі вже налаштовані під мови.
- Обмежувати використання жирного накреслення — в деяких мовах токени його відмикають, краще виділяти розміром або кольором.
6.3. Макет і компонування
- Передбачати дзеркальні макети для RTL (і текст, і іконки, і навігація).
- По можливості збирати інтерфейс на auto‑layout.
- Не вшивати текст у зображення — це ускладнює локалізацію.
- Закладати запас простору навколо тексту, щоб при перекладі не виникало візуальної «тісноти».
6.4. Мовні й форматні особливості
- Коректно відображати формати дати (YYYY/MM/DD vs MM/DD/YYYY) залежно від регіону.
- Враховувати метричну/імперську систему.
- Тестувати і LTR, і RTL‑потоки.
6.5. Перевірка локалізаційної готовності
- Не покладатися на ідіоми, жаргон, культурно прив’язаний гумор у UI‑текстах.
- За потреби резервувати місце для локалізованих зображень.
- Використовувати плагіни на кшталт Translator для швидкого тесту макетів з перекладом.
- Залучати носіїв мови для юзабіліті‑перевірки.
- Окремо проганяти сценарії з дзеркальними макетами для RTL.
7. Ключові висновки кейсу SAS Filament
З досвіду авторів видно кілька практичних уроків, важливих для будь‑якої дизайн‑системи:
- Локалізація та інтернаціоналізація — частина фундаменту, а не фінальний шар. Якщо планується глобальний продукт, закладати їх треба на рівні токенів і компонентів.
- Семантичні токени полегшують масштабування — прив’язуватися краще до ролі (heading, body, action), а не до конкретних чисел і кольорів.
- Figma Variables дають лише частину рішення — зокрема, зараз складно узгодити відсоткові лінійні інтервали й деякі веб‑особливості типографіки.
- Автоматизація критична — там, де інструменти не дають повної автоматизації, зростає ризик помилок (ручне введення сотень line‑height, очистка ghost variables).
- Співпраця з розробкою обов’язкова — рішення на рівні структури JSON і категоризації мов без фронтенду важко зробити ефективно.
- Тестувати потрібно на реальному контенті — тільки так виявляються кейси переповнення, проблемні поєднання шрифтів, збої в RTL.
Цей кейс показує практичний шлях: від «англомовних макетів» до системи, де в одному й тому ж Figma‑компоненті можна перемикати тему, щільність і мовну категорію через токени та variables. Для власної дизайн‑системи ви можете адаптувати ту ж логіку категоризації токенів, мінімізації JSON‑файлів і підходи до тестування багатомовних макетів.
Джерело: Rebecca Hemstad & Mark Malek – Smashing Magazine. Дата оригіналу: 2025-05-12.